Un homelabber exécute un modèle IA de 2,8 trillions de paramètres sur de la mémoire Intel Optane, sans GPU
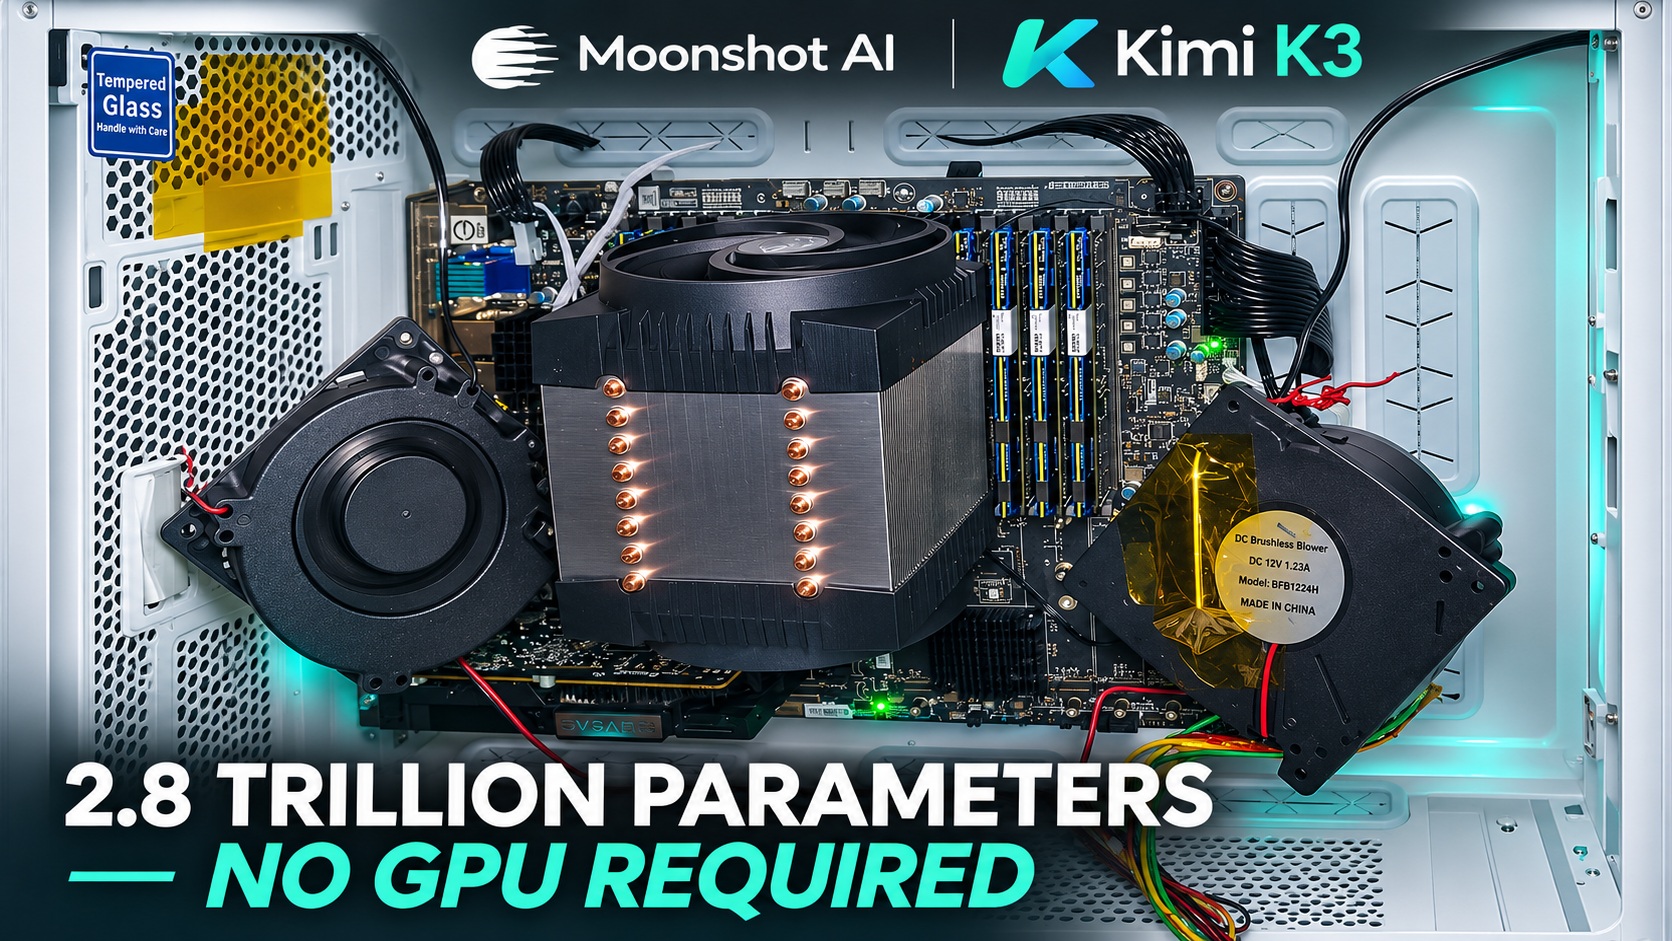
Un passionné de hardware a réussi l’exploit de faire tourner l’un des plus grands modèles d’IA en accès libre sur un serveur uniquement équipé d’un CPU, sans aucune carte graphique. La clé de cette prouesse réside dans l’utilisation de barrettes mémoires Intel Optane en fin de vie, offrant une capacité colossale pour un budget bien inférieur à la RAM serveur classique.
Une expérience hors-norme avec le modèle Kimi K3
Partagée par l’utilisateur Reddit IndividualSurvival, cette expérience consiste à exécuter Kimi K3 de Moonshot AI, un modèle Mixture-of-Experts (MoE) de 2,8 billions de paramètres, sur un processeur Intel Xeon Scalable de troisième génération à 40 cœurs.
Pour chaque jeton traité, Kimi K3 active environ 104 milliards de paramètres, avec une fenêtre contextuelle théorique d’un million de jetons. Même ses versions fortement quantifiées nécessitent plusieurs centaines de gigaoctets de mémoire, rendant le matériel grand public incapable d’exécuter le modèle complet en local.
La mémoire Intel Optane, élément clé du projet
Plutôt que d’investir une fortune dans de la DDR4 haute capacité ou des GPU professionnels coûteux, l’enthousiaste a choisi des modules Intel Optane Persistent Memory 200 Series de seconde main, aussi appelés Barlow Pass.
Ces modules proposent une mémoire persistante et adressable par octet, avec des capacités allant jusqu’à 512 Go par barrette. Bien qu’Intel ait arrêté le développement d’Optane en 2022, les modules d’occasion restent une option intrigante pour les passionnés travaillant sur des charges mémoire intensives.
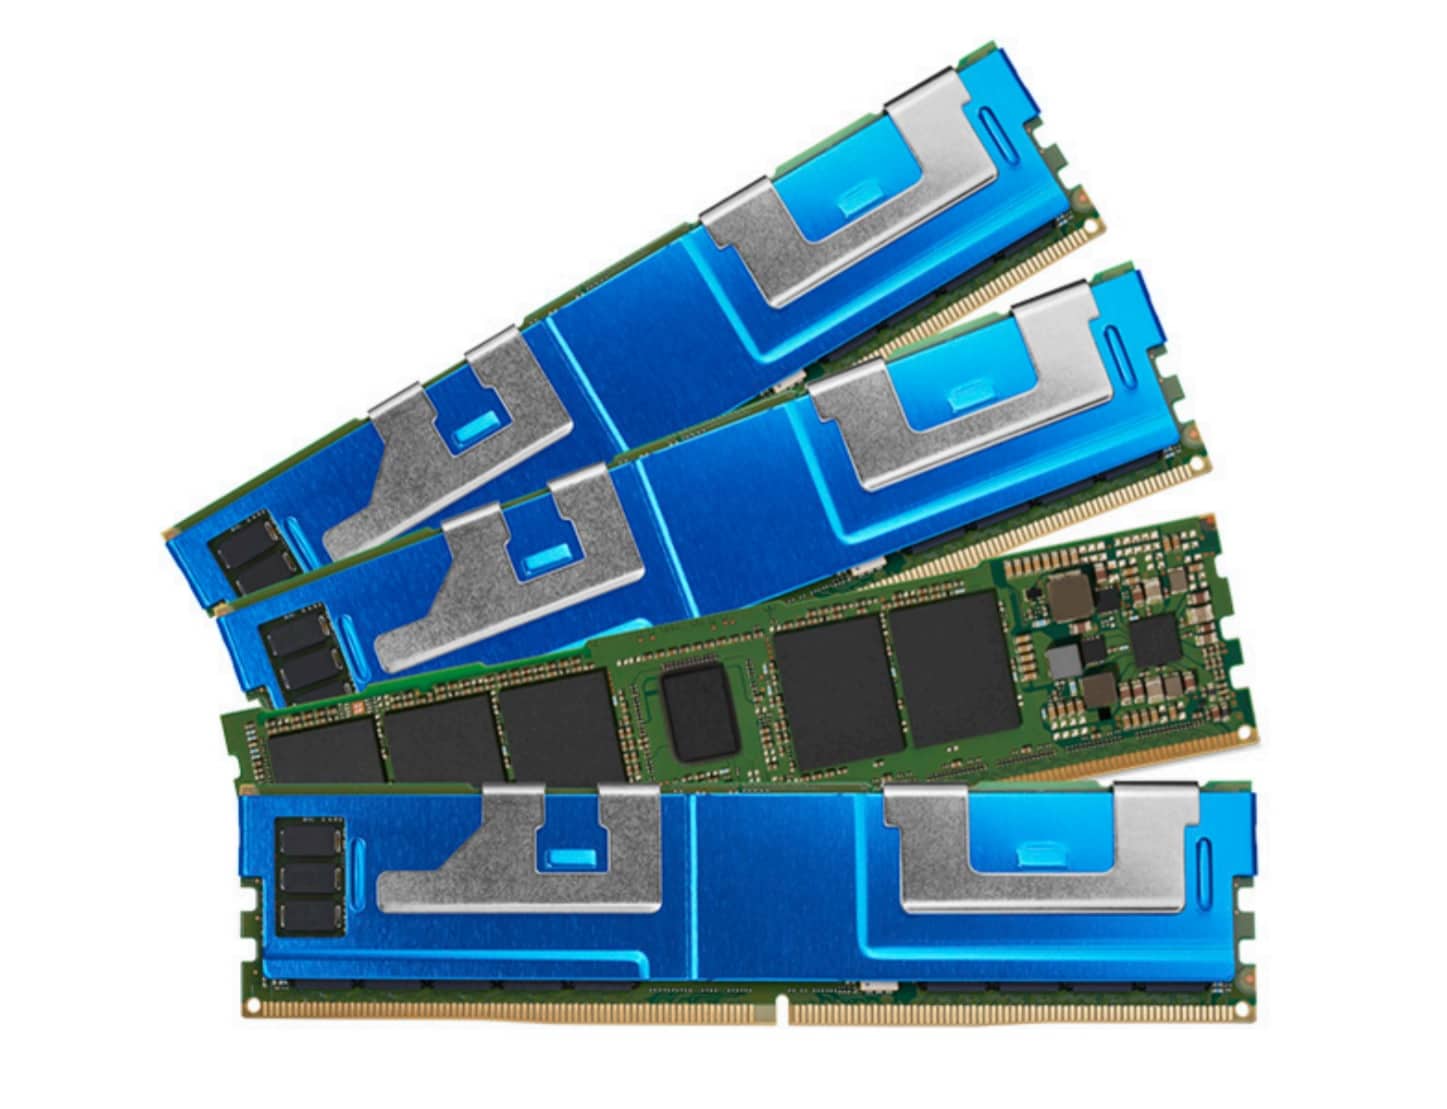
En utilisant llama.cpp avec Optane configuré en mode App Direct, le constructeur a réussi à charger le modèle sans avoir besoin d’accélération graphique. Cette configuration diffère du mode Memory traditionnel, où la RAM système sert de cache géré matériellement pour Optane.
Les premières performances étaient logiquement modestes, atteignant seulement 0,85 jetons par seconde avec une quantification 1-bit. Toutefois, la désactivation de l’accès direct (DAX) a augmenté le débit à 1,50 jeton par seconde, soit une amélioration d’environ 76%.
L’explication est simple : DAX contourne le cache de pages du système, alors que sa désactivation permet aux données fréquemment utilisées de profiter de la mise en cache plus rapide de la DRAM.
Un test séparé avec une quantification 3-bit a atteint environ 0,75 jeton par seconde. À cette vitesse, générer 50 000 jetons prendrait près de 18,5 heures, illustrant les importants compromis de performance. De plus, une quantification 1-bit agressive peut nuire à la précision du modèle.
La gestion thermique, défi majeur des modules Optane
La découverte la plus importante concerne peut-être le comportement thermique des modules de mémoire persistante d’Intel.
Sous des charges d’inférence soutenues, les barrettes Optane produisent beaucoup de chaleur. Selon les spécifications d’Intel, chaque module peut fonctionner avec des niveaux de puissance allant jusqu’à 18W, le throttling thermique débutant à 83°C et l’arrêt protecteur à 85°C.
L’expérimentateur a signalé qu’une ventilation inadéquate pouvait aussi menacer les modules de mémoire DDR4 ECC adjacents, bien qu’aucune panne réelle n’ait été documentée.
Pour résoudre ce problème, il a installé deux ventilateurs soufflants dédiés de 12W pointés directement vers les barrettes, ramenant apparemment les températures sous contrôle.
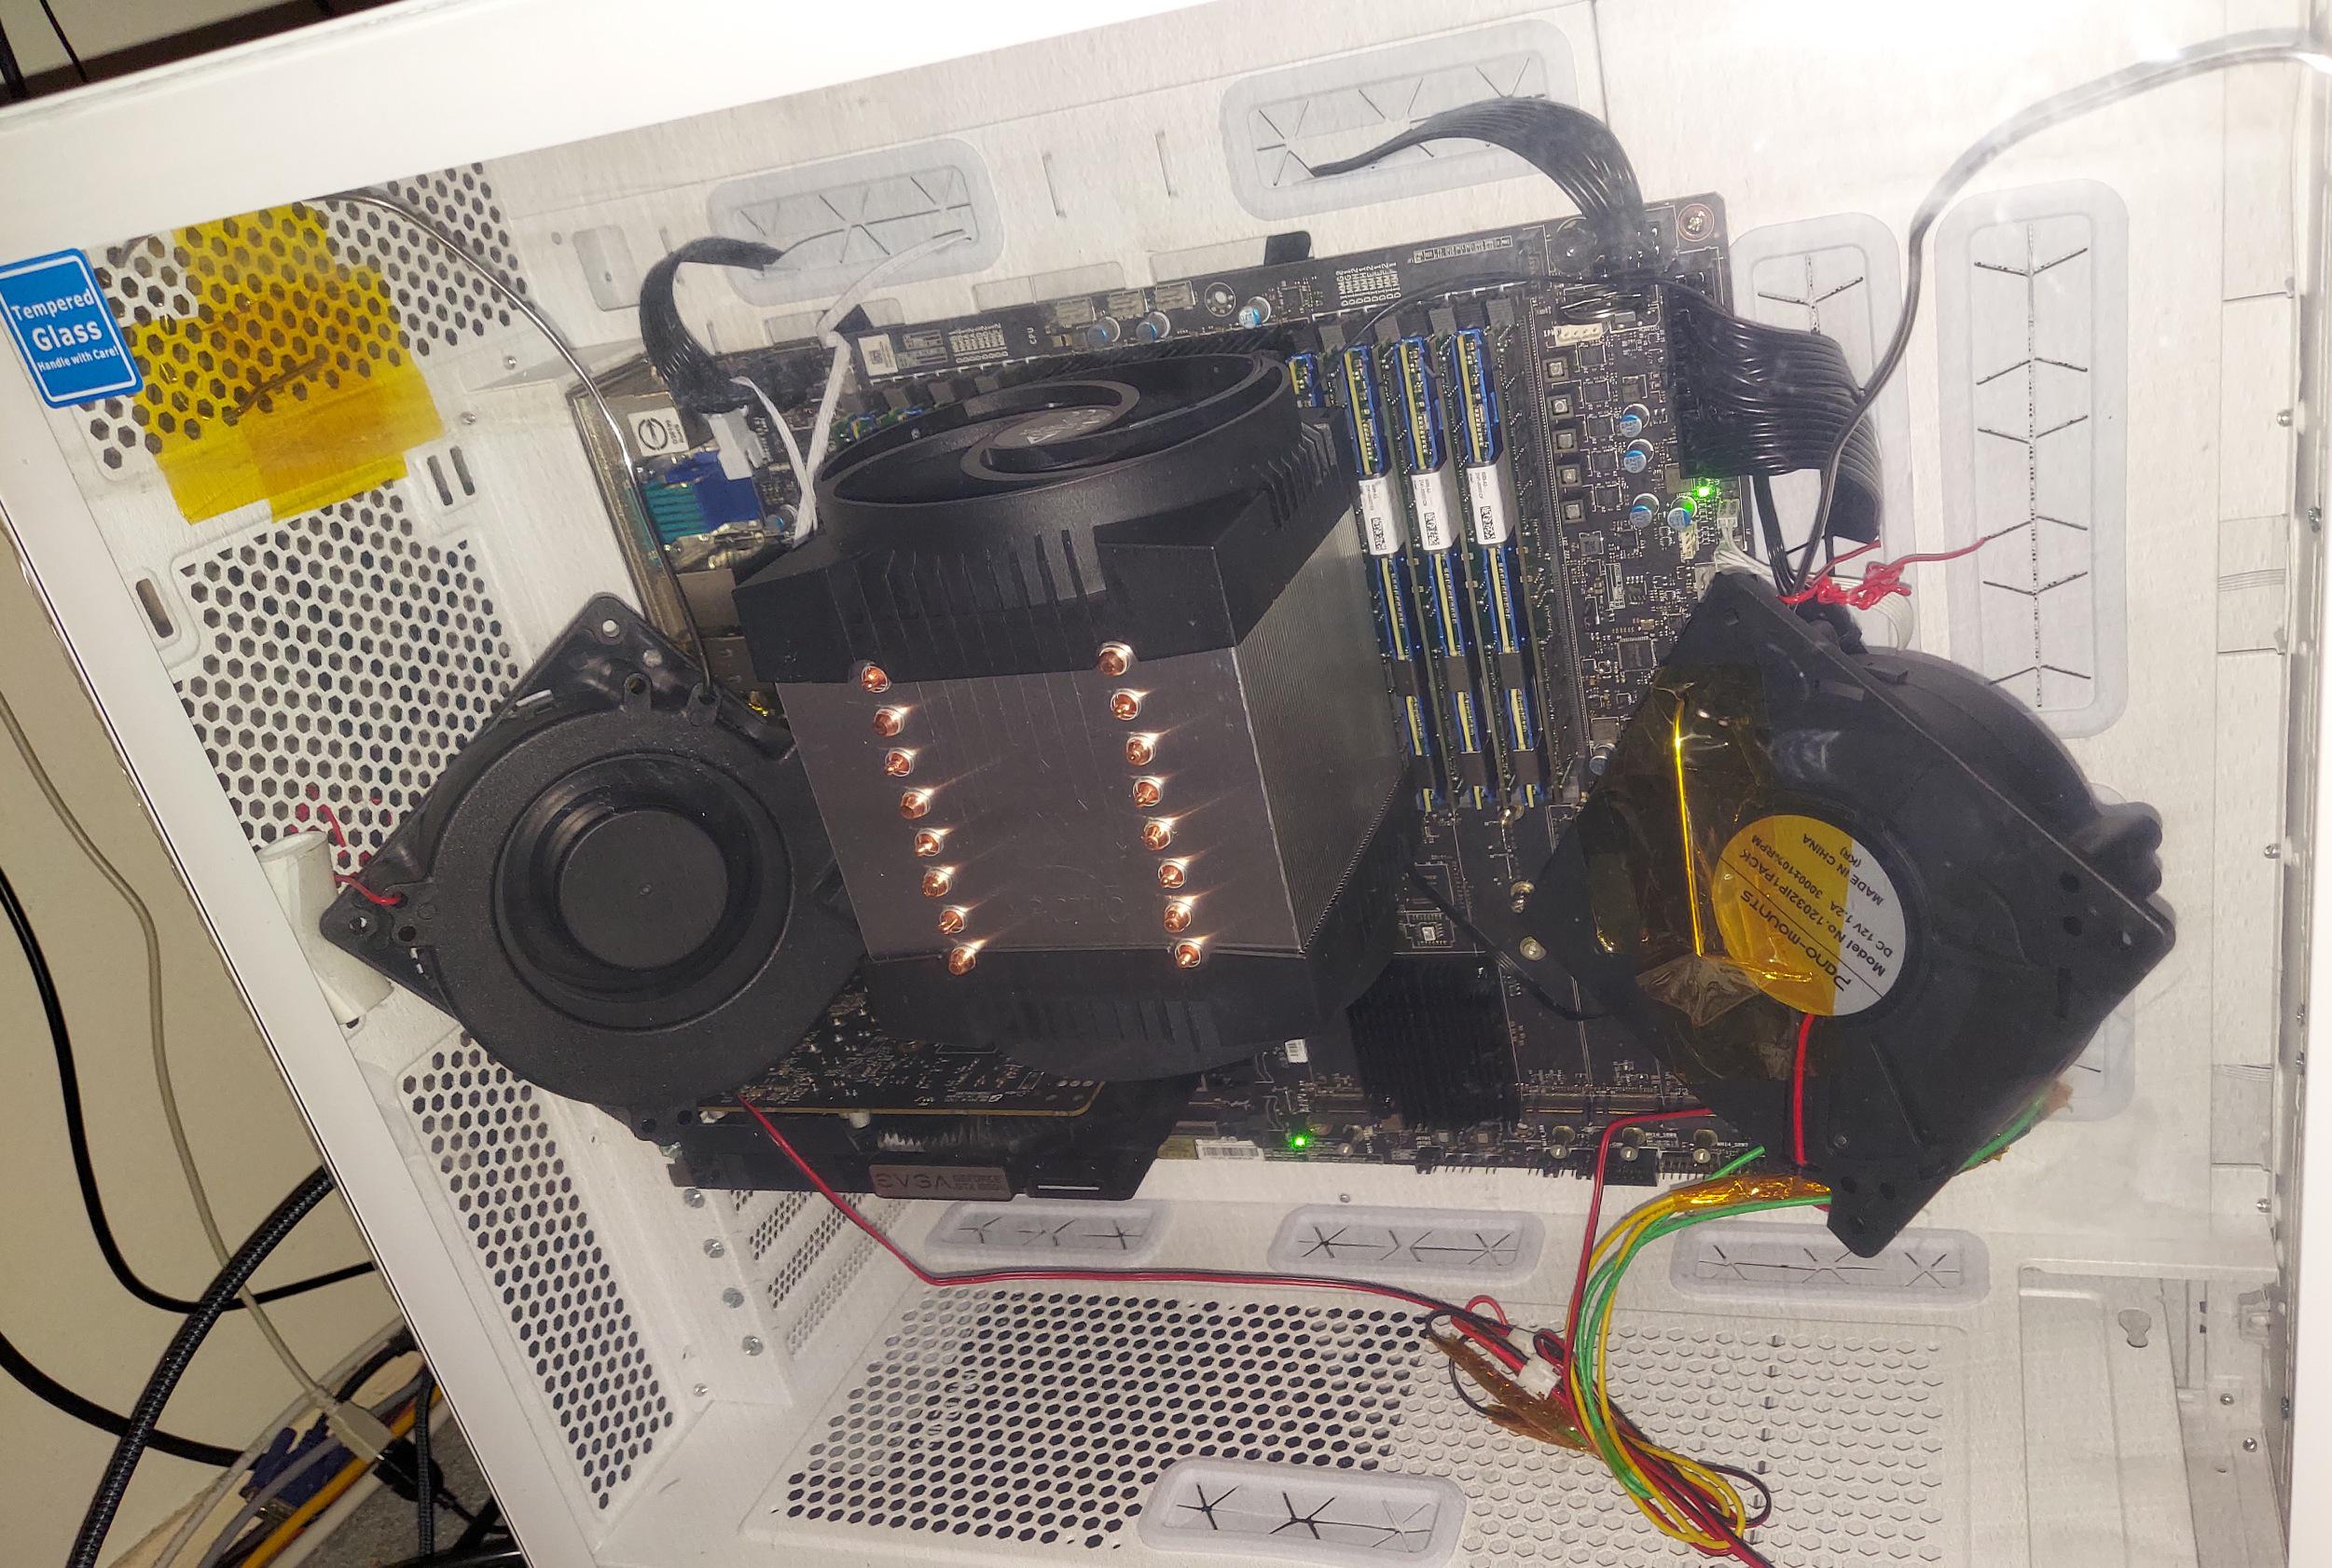
Malgré des performances limitées, cette expérience montre comment du matériel d’entreprise vieillissant peut trouver des applications non conventionnelles dans les charges de travail modernes d’IA.
Le constructeur prévoit d’expérimenter avec l’accélération graphique et des configurations hybrides DRAM/Optane pour améliorer les vitesses d’inférence. Reste à voir si ces optimisations rendront ce montage inhabituel réellement pratique.
Source : r/homelab subreddit