NVIDIA : les chiplets ont sacrifié la performance mono-thread, l’IA agentique force un revirement
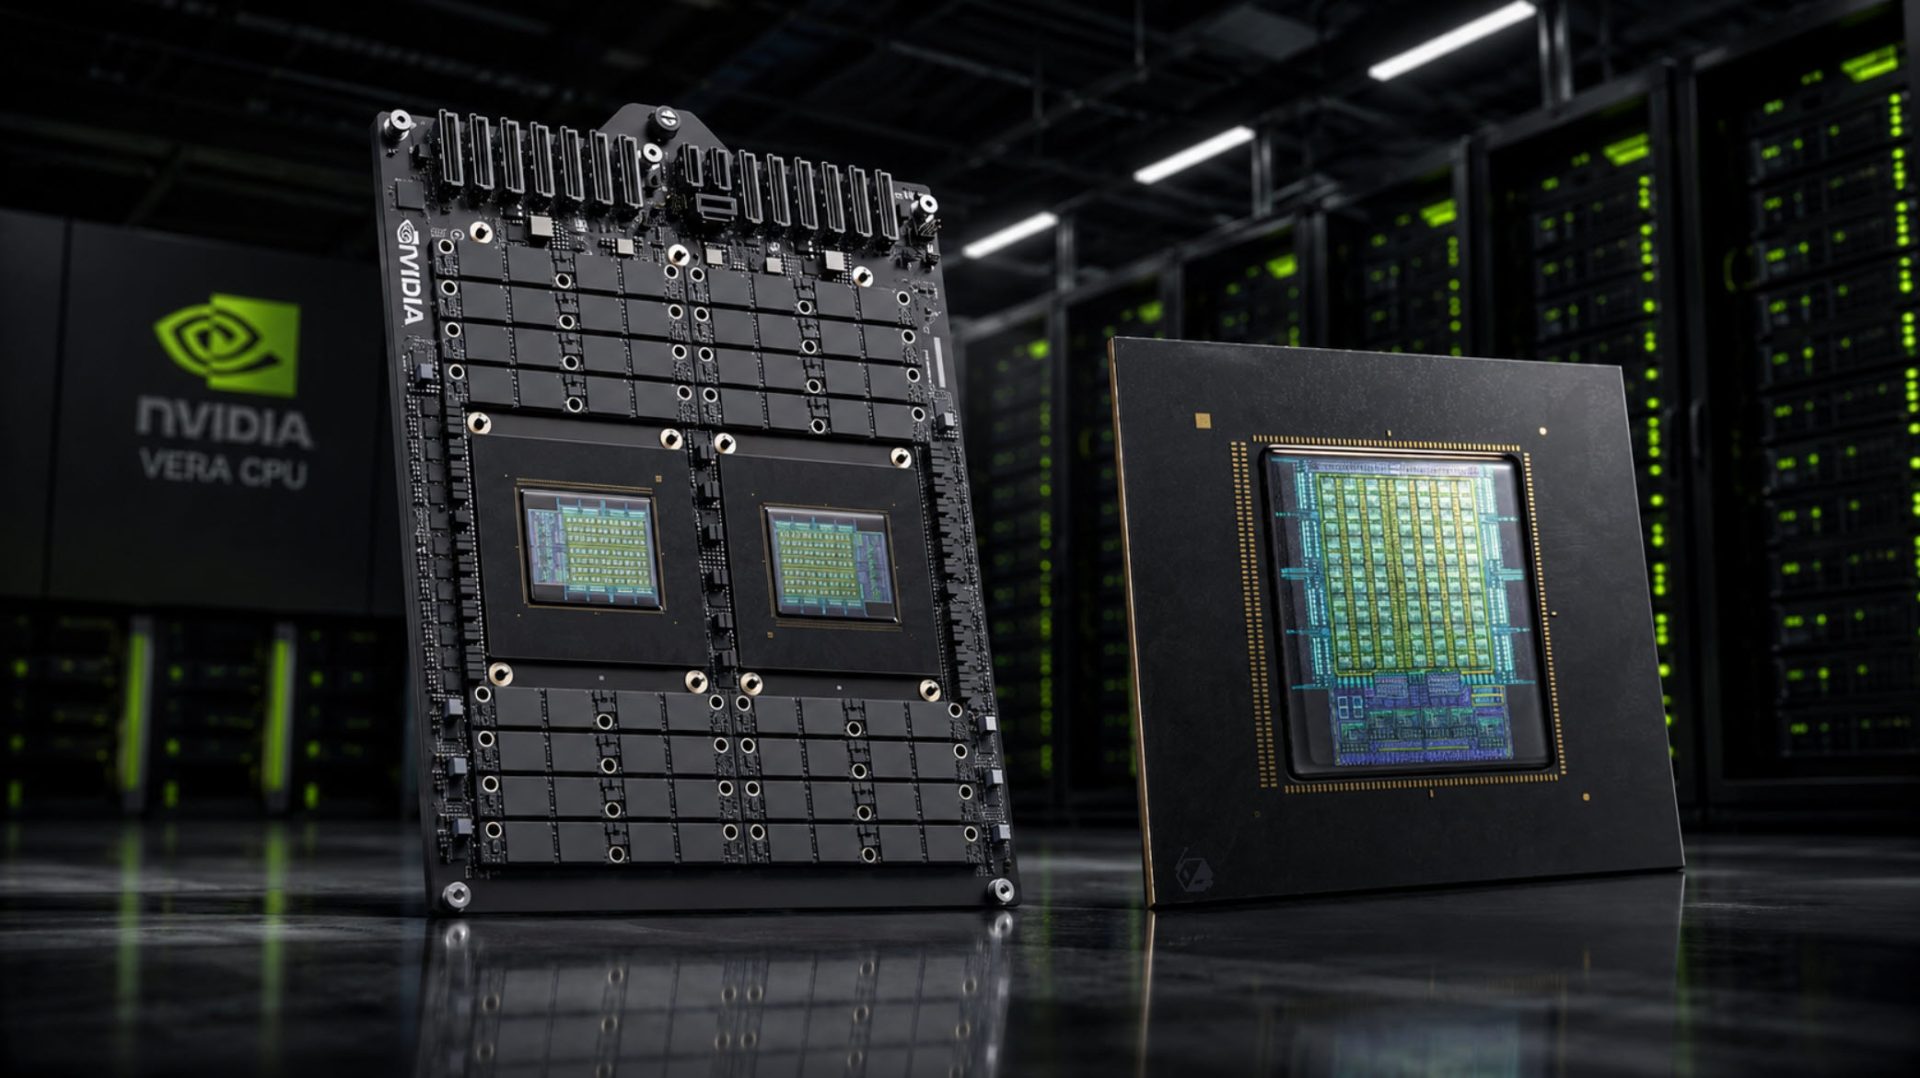
L’arrivée du CPU Vera de NVIDIA marque un tournant pour l’informatique orientée IA. Ce processeur, conçu spécifiquement pour piloter l’intelligence artificielle agentique, abandonne les approches généralistes pour se spécialiser dans la gestion des boucles de raisonnement complexes. Il s’agit d’une réponse directe aux besoins critiques en latence et en bande passante mémoire imposés par les agents IA modernes.
Le CPU Vera, une réponse au renouveau de la performance mono-coeur
Le CPU Vera de NVIDIA inaugure une nouvelle approche de l’architecture informatique, passant d’un modèle traditionnel à un écosystème d’intelligence orchestrée. Il transforme le processeur central d’un simple multitâche en un chef d’orchestre spécialisé, dédié à la gestion des processus séquentiels des agents IA.
Nous avons récemment échangé avec l’équipe en charge du projet Vera chez NVIDIA pour discuter du rôle émergent du CPU dans l’économie de l’IA agentique. Nous abordons le retour en force des performances mono-coeur, l’ampleur des environnements de test gérés par le CPU et l’évolution du ratio CPU/GPU.
« C’était une période où Intel dominait le segment des centres de données… on obtient de hautes performances mono-coeur mais un faible débit car le nombre de cœurs est limité. »
Avec l’essor des hyperscalers, l’industrie s’est tournée vers l’économie d’échelle. La demande s’est concentrée sur l’empilement d’un maximum de cœurs dans un serveur pour maximiser le retour sur investissement. Pour atteindre cette densité et contrôler les coûts, les fondeurs x86 sont passés des puces uniques aux assemblages de chiplets. Cette expansion massive du nombre de cœurs s’est cependant faite au détriment de l’optimisation mono-coeur et des IPC (Instructions Par Cycle).
Cette ère se situe dans le quadrant inférieur droit, offrant un débit massif mais de faibles performances mono-coeur.
« …ce qui a souffert pendant cette période en termes de conception CPU, ce sont vraiment les performances mono-coeur et les IPC. Lorsqu’on utilise des chiplets, on n’a tout simplement pas l’espace sur la puce pour optimiser les performances par cœur. »
L’émergence de l’IA agentique replace le CPU au centre de la conception matérielle. Les agents IA opèrent dans une boucle continue et rapide entre le GPU et le CPU. Comme les GPU sont les composants les plus coûteux d’une usine IA, le CPU doit accomplir ses tâches séquentielles instantanément pour éviter que le GPU reste inactif. Ce nouveau paradigme exige une combinaison inédite de vitesse, d’accès mémoire et de latence minimale.
« …vous voulez que l’agent termine son travail séquentiel sur le CPU, puis retourne sur le GPU pour l’étape de raisonnement suivante, car vos GPU restent parmi vos actifs les plus précieux. Vous ne voulez pas que ces actifs coûteux restent sous-utilisés… »
Le CPU Vera de NVIDIA résout ce goulot d’étranglement en brisant les compromis historiques de l’ère cloud, se positionnant dans le quadrant supérieur droit : hautes performances mono-coeur couplées à un haut débit. Il y parvient grâce à trois choix de conception : une vitesse élevée par cœur, un sous-système mémoire LPDDR5X personnalisé pour une bande passante massive, et une puce de calcul monolithique unique alimentée par la deuxième génération du NVIDIA Scalable Coherent Fabric pour éliminer la latence.
« …c’est une puce monolithique unique. Tous les cœurs sur cette puce de calcul peuvent communiquer entre eux sans franchir de limites d’E/S et sans générer de latence. C’est vraiment la base de ce qu’est Vera, ce qui le différencie et ouvre une nouvelle catégorie. Ce n’est ni le CPU d’avant le cloud, ni le CPU de l’ère cloud. C’est la case supérieure droite du quadrant, avec de hautes performances mono-coeur et un haut débit. »
En résumé : Vera est le premier CPU de NVIDIA conçu spécifiquement pour l’IA agentique, visant à résoudre les goulots d’étranglement de l’ère IA moderne. Alors que l’ère cloud privilégiait le débit avec des cœurs nombreux mais peu performants, l’IA agentique nécessite une boucle rapide entre GPU et CPU. Pour maintenir une utilisation optimale des GPU coûteux, les agents exigent de hautes performances mono-coeur, une large bande passante mémoire et une faible latence. Vera y parvient grâce à une puce monolithique, un sous-système mémoire LPDDR5X personnalisé et une deuxième génération de Scalable Coherent Fabric, le plaçant dans une nouvelle catégorie alliant performance mono-coeur et débit élevé.
Désagrégation des fonctions CPU, cœurs Olympus et taxe de performance
Question : Avec l’annonce du HTPU par SK Hynix, qui intègre une centaine de micro-processeurs dans un SSD pour gérer des tâches bas niveau, laissant le processeur principal se concentrer sur des opérations plus complexes, NVIDIA s’intéresse-t-elle à une forme similaire de désagrégation des fonctions CPU ?
Réponse : Le paysage de l’infrastructure IA s’éloigne des nœuds serveur uniformes pour se diriger vers des configurations hétérogènes hautement spécialisées. Un exemple frappant de cette tendance concerne les charges de travail d’inférence IA modernes, où les phases distinctes de traitement – la lecture initiale des données (pré-remplissage) et la génération séquentielle de tokens (décodage) – sont désormais systématiquement réparties sur des clusters matériels totalement distincts pour optimiser l’efficacité.
« Je dirais qu’il y a beaucoup de désagrégation dans l’espace des infrastructures IA en général. Prenons l’inférence et la séparation du pré-remplissage et du décodage sur des infrastructures distinctes. C’est une tendance majeure vers une infrastructure hétérogène. »
La stratégie CPU initiale de NVIDIA, avec le processeur Grace, visait à créer le « nœud hôte » ultime – un processeur conçu pour alimenter un cluster de GPU au sein d’un rack serveur. Cependant, les exigences uniques des flux de travail agentiques et de l’apprentissage par renforcement ont forcé un changement de cap, NVIDIA ayant réalisé qu’il existait un cas d’usage pour des racks de CPU purs afin de gérer les appels d’outils d’agents et les tâches d’apprentissage par renforcement.
« …nous nous concentrions sur Grace en tant que nœud hôte, le CPU pour 1 à 8 GPU dans un rack. Nous voulions le meilleur nœud hôte possible. Puis nous avons constaté qu’il y avait en réalité un besoin pour de nombreux CPU autonomes, des racks entiers de CPU purs, pour tous ces appels d’outils d’agents et l’apprentissage par renforcement… »
En raison de ce pivot, le CPU Vera n’est plus considéré comme un simple composant intégré dans une architecture GPU-CPU combinée (comme la pile Vera-Rubin). Au contraire, Vera est commercialisé comme un actif CPU autonome et indépendant, avec des « racks purs » de processeurs Vera dédiés au traitement massif d’appels d’outils d’agents et de boucles de raisonnement.
« …ce pivot s’apparente à une forme de désagrégation. Au lieu de n’être qu’une partie de la pile Vera-Rubin, nous pensons qu’il est important d’avoir Vera comme CPU autonome. Pour répondre à votre question, ce pivot avec Vera est en soi un pas dans cette direction. Mais je ne peux pas commenter sur le cas d’usage spécifique que vous décrivez. »
En résumé : Bien qu’elle ne puisse commenter le cas spécifique de SK Hynix, NVIDIA observe une forte tendance à la désagrégation dans les infrastructures IA. Le pivot de Vera représente un pas dans cette direction, NVIDIA ayant identifié un besoin de marché pour des racks massifs de CPU autonomes dédiés aux appels d’outils d’agents et à l’apprentissage par renforcement, plutôt que de simples nœuds hôtes dans une pile unifiée.
Question : NVIDIA annonce environ 50% d’IPC en plus que Grace, avec une largeur de décodage de 10 instructions. En cas de mauvaise prédiction de branchement, quelle est la latence ? Combien de cycles faut-il à Vera pour récupérer par rapport à Grace ?
Réponse : Le CPU Vera réalise un bond en avant, offrant des performances 1,5 fois supérieures à son prédécesseur, Grace. Face aux meilleurs processeurs x86 du marché sur des charges de travail agentiques, qui reposent fortement sur des tâches séquentielles comme l’exécution de scripts Python ou la compilation de code, Vera est jusqu’à 2 fois plus rapide, avec un avantage moyen de 1,6x.
« …nous sommes 1,5 fois plus rapides que Grace, et 2 fois plus rapides sur les charges agentiques face au meilleur composant x86. »
Au lieu du Multithreading simultané traditionnel, NVIDIA implémente une capacité native appelée Multithreading spatial. Cette fonction propriétaire permet au silicium de provisionner de manière rigide des threads « travail » et des threads « E/S » dédiés. Cette division garantit que, même sous des charges de calcul intenses, un cœur ne privera jamais ses threads de traitement principaux de cycles pour gérer des opérations de fond.
« …NVIDIA emploie son propre multithreading spatial… Il permet de provisionner un thread comme thread de travail et un autre comme thread d’E/S. C’est un moyen d’avoir une allocation de ressources plus optimale. Souvent, dans d’autres architectures concurrentes, vous pourriez voler des cycles à votre thread de travail pour alimenter les E/S ou d’autres cœurs à cause de la charge. Notre multithreading spatial permet de maintenir cet équilibre des ressources. »
Pour répondre aux inquiétudes quant à une éventuelle latence introduite par cette planification complexe, des tests indépendants ont confirmé l’absence de pénalité de performance. Un test approfondi publié par le site Phoronix a vérifié que le multithreading spatial de NVIDIA apporte un gain d’efficacité notable.
« …Phoronix a publié un article il y a une semaine… ils ont confirmé que le SMT de NVIDIA sur Vera procure environ 20% de performances en plus. Ce n’est pas une taxe, c’est même l’inverse. »
En résumé : Vera est 1,5 fois plus rapide que Grace globalement, et jusqu’à 2 fois plus rapide que les principaux concurrents x86 sur des charges agentiques. Le multithreading spatial propriétaire de NVIDIA n’entraîne pas de pénalité. Il provisionne des threads de travail et d’E/S pour maintenir un équilibre optimal des ressources même sous forte charge. Une analyse tierce par Phoronix a confirmé que cette technologie apporte environ 20% de performances supplémentaires.
Le point de vue de NVIDIA sur le ratio CPU/GPU
Question : Lors du lancement de son agent Muse, Meta a laissé entendre que le ratio CPU/GPU dans les environnements IA pourrait atteindre 80:1. Est-ce réaliste, et comment cela affecte-t-il la demande pour Vera ?
Réponse : NVIDIA n’endosse ni ne projette officiellement le ratio 80:1. Cependant, le volume industriel d’appels d’outils d’agents est colossal, certains fournisseurs d’environnements de test hébergeant jusqu’à 400 000 sandbox pour un seul client. Le ratio d’infrastructure évolue activement et massivement en faveur des CPU pour supporter des billions d’environnements d’exécution, ce qui motive la poussée de NVIDIA vers des racks autonomes de CPU Vera.
« Pour être honnête, nous n’avons tout simplement pas de point de vue sur la question du ratio. On nous le demande souvent, mais nous n’en avons pas. Vous pouvez imaginer pourquoi nous ne voudrions rien affirmer publiquement, car cela signalerait immédiatement quelque chose sur l’orientation de l’activité. L’équipe CPU n’a même pas d’idée précise du nombre final, mais nous croyons que c’est un chiffre qui évolue, et il évolue en faveur des CPU. C’est pourquoi nous déployons tous ces efforts pour que le marché comprenne l’intérêt de Vera, que c’est le CPU pour l’agentique. Si vous souhaitez déployer des racks de CPU autonomes pour l’IA agentique ou l’apprentissage par renforcement, nous espérons que vous penserez à Vera. »
La puce monolithique du NVIDIA Vera
Question : Pourquoi NVIDIA a-t-elle choisi une puce monolithique pour Vera au lieu de l’architecture par chiplets utilisée par ses concurrents ?
Réponse : Contrairement aux fondeurs x86 historiques qui doivent concevoir des architectures complexes et flexibles pour servir à la fois les PC grand public et les centres de données haut de gamme, NVIDIA est entré sur le marché des CPU autonomes sans les contraintes des segments passés. Ce positionnement unique leur a offert le luxe de concevoir Vera exclusivement pour une seule cible : le centre de données IA ultra-performant.
« …Vera est vraiment le premier que nous positionnons ainsi, car nous ne sommes pas encombrés par les segments du passé… AMD et Intel doivent servir non seulement le data center, mais aussi le client. Ils ont différents segments à servir avec une seule architecture… Nous avons eu le luxe de concevoir strictement pour le marché des centres de données. »
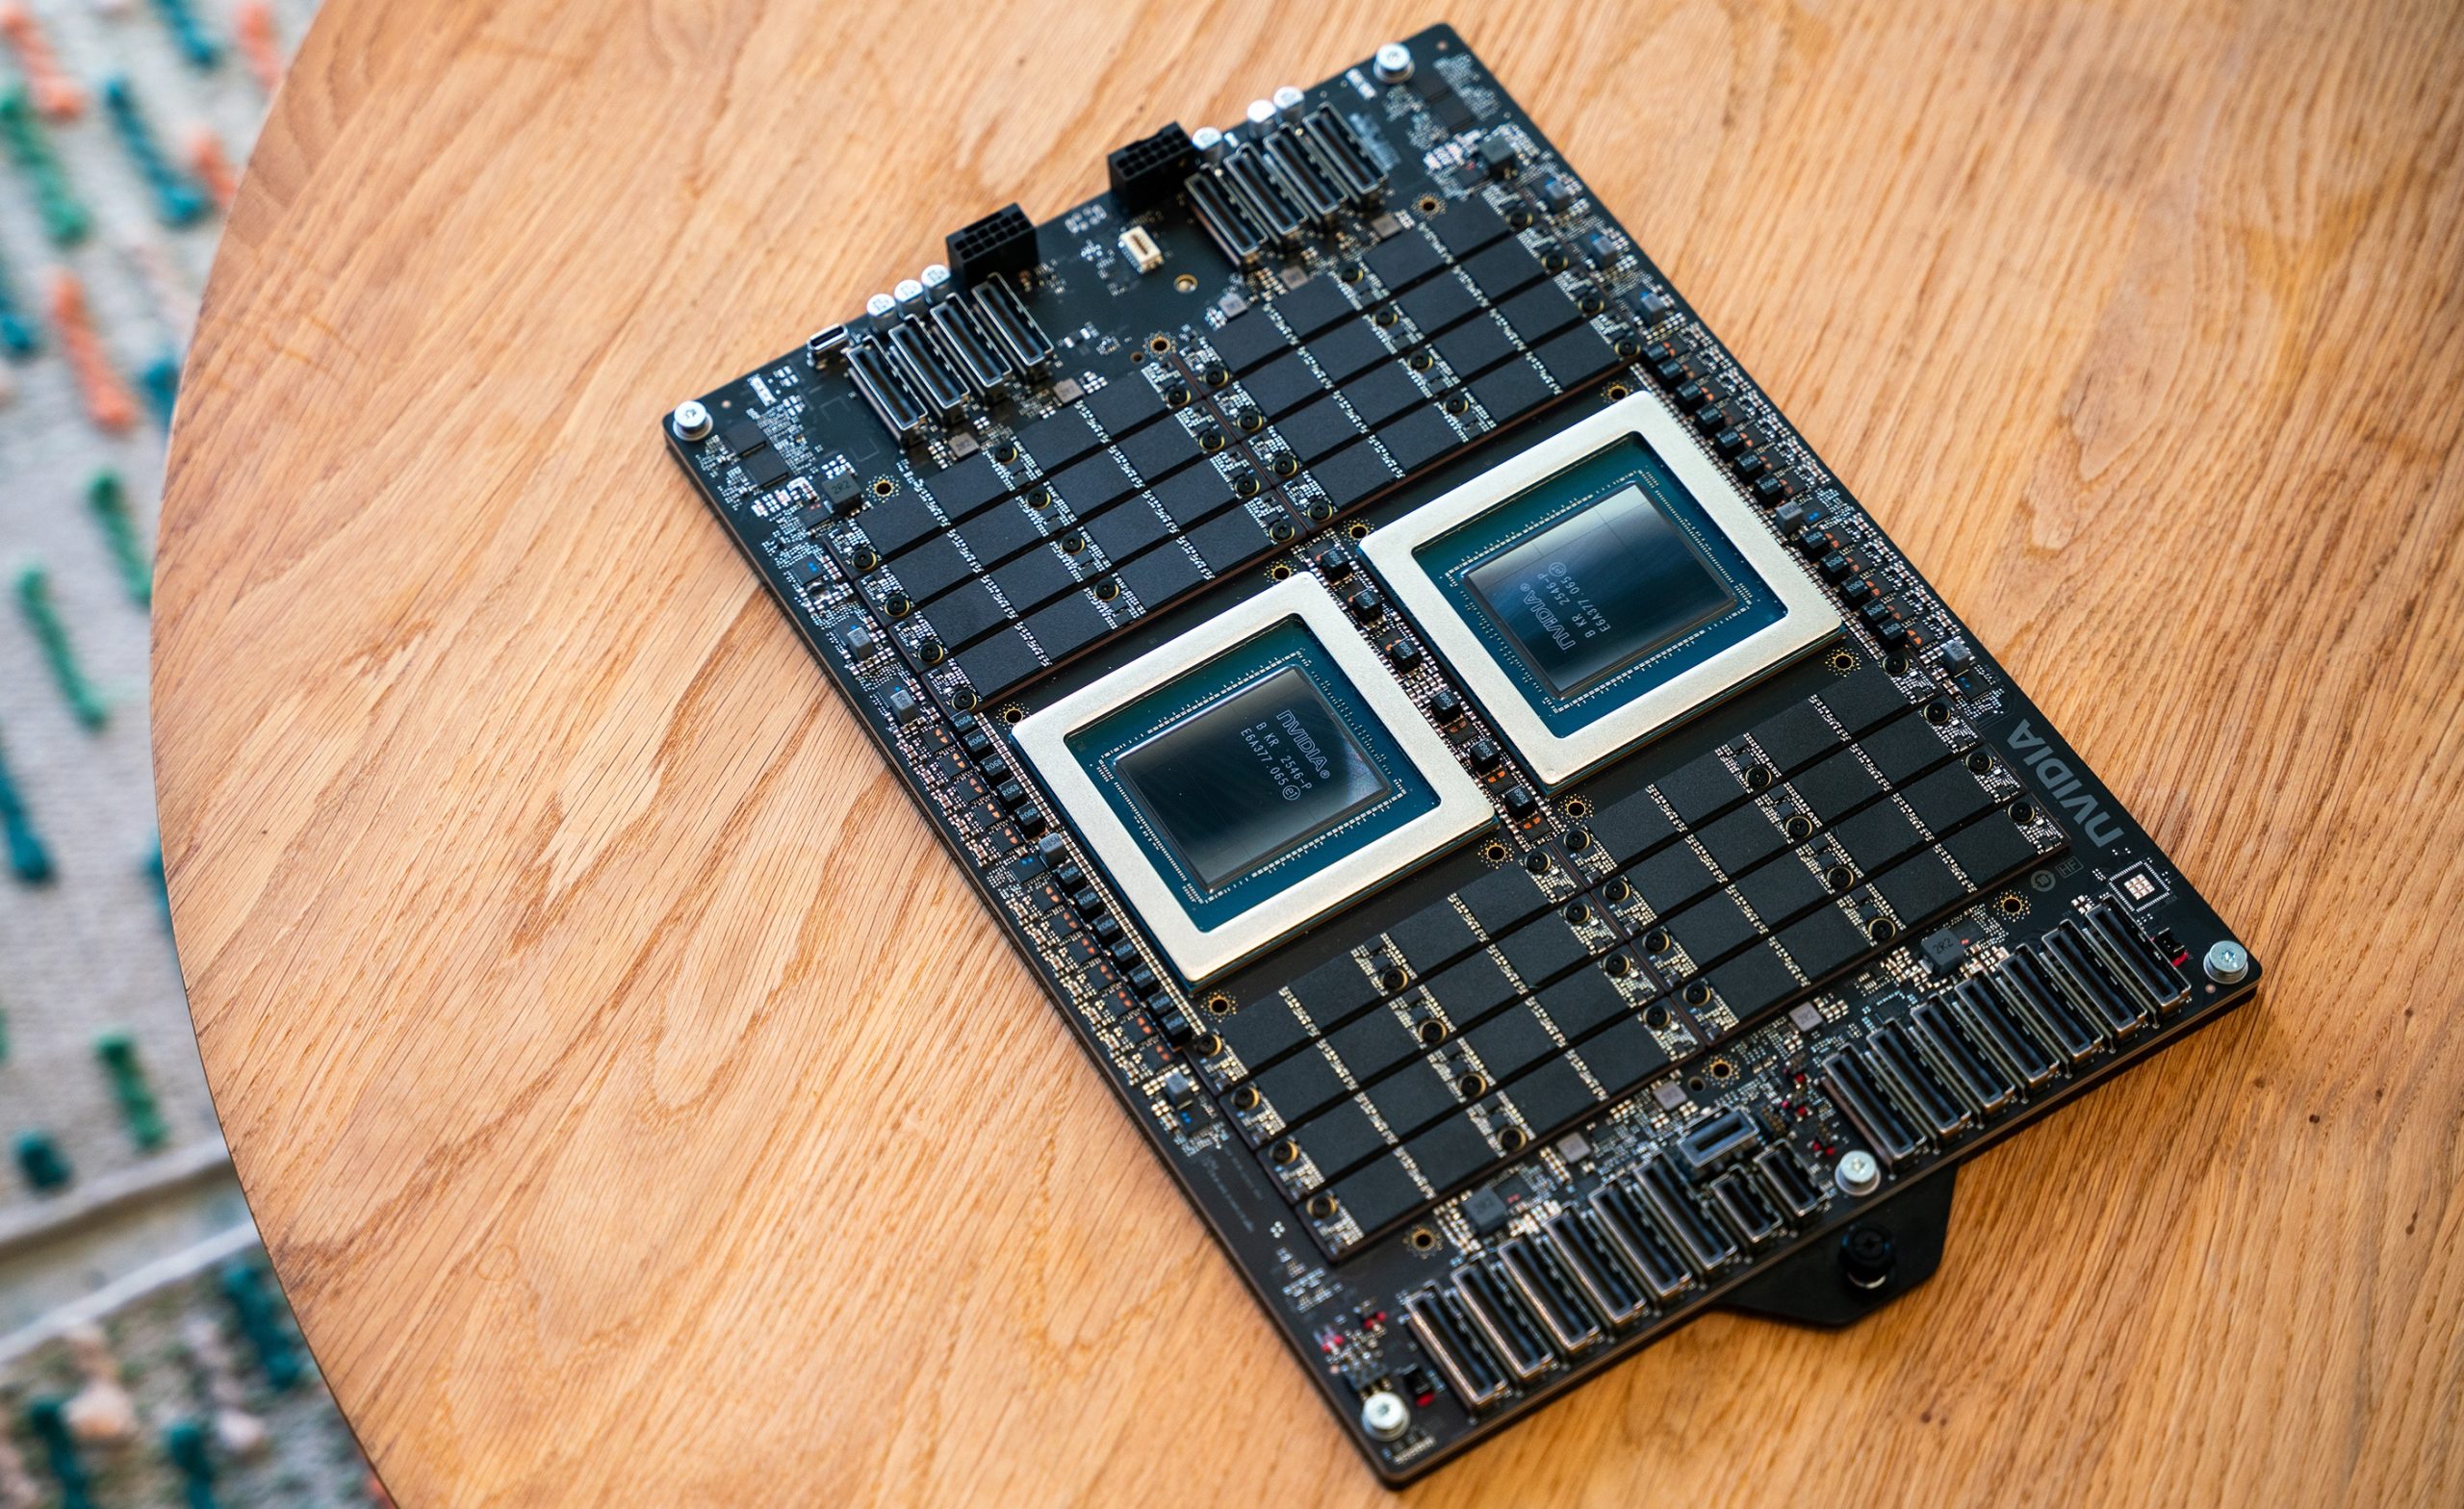
Pour satisfaire les boucles intenses d’accès mémoire des agents IA et du traitement analytique, NVIDIA a délibérément rejeté la tendance multi-chiplet de ses concurrents au profit d’une puce monolithique unique. En gardant tous les cœurs sur un seul morceau de silicium continu, NVIDIA a pu éliminer complètement la « taxe » de performance interne qui survient lorsque les données sont forcées de communiquer entre des chiplets séparés.
« …avoir une puce monolithique, où le cœur dans le coin supérieur gauche peut parler au cœur dans le coin inférieur droit sans franchir de limites d’E/S et sans subir d’attaques [de latence], c’était un point de conception précieux pour nous… c’était important pour notre objectif de maximiser les mouvements de données, non seulement pour l’IA agentique, mais aussi pour le traitement et l’analyse de données classiques. »
Cette ingénierie monolithique se traduit par un avantage massif pour le calcul collaboratif. Le CPU Vera atteint un débit bisectionnel record de 3,4 téraoctets par seconde, permettant aux cœurs individuels de collaborer et de partager des informations contextuelles 3 fois plus vite que les meilleures puces x86.
« …nous pouvons fournir 3,4 To/s de débit bisectionnel, ce qui est 3 fois supérieur à la meilleure puce x86. Cela signifie que lorsque des cœurs doivent collaborer sur un contexte partagé, ils le font trois fois plus vite que sur une puce x86. »
Bien que l’approche monolithique ait été mathématiquement nécessaire pour atteindre les objectifs de performance spécifiques de Vera, NVIDIA maintient une position hautement pragmatique et agnostique vis-à-vis de la technologie des chiplets pour l’avenir. L’entreprise adoptera des conceptions par chiplets si une opportunité de marché future l’exige, privilégiant l’utilité technique à des philosophies de conception rigides.
« …je pense que nous allons être très équilibrés sur les points de conception que nous voulons atteindre en fonction des opportunités de marché… Je ne dirais pas que nous avons une religion sur la question. C’est plutôt : qu’est-ce qui est juste pour ce que nous cherchons à accomplir ? »
En résumé : NVIDIA, libérée des exigences des segments hérités, a le luxe de concevoir ses puces strictement pour le data center et l’IA agentique. Une puce monolithique maximise le mouvement des données en permettant aux cœurs de communiquer sans franchir de limites d’E/S, offrant un débit bisectionnel de 3,4 To/s, soit 3 fois plus que les meilleures puces x86. NVIDIA reste toutefois ouverte aux architectures par chiplets à l’avenir si les demandes du marché l’exigent.