IBM ouvre son procédé 0,7 nm aux fondeurs dès 2027, pour miniaturiser les puces IA
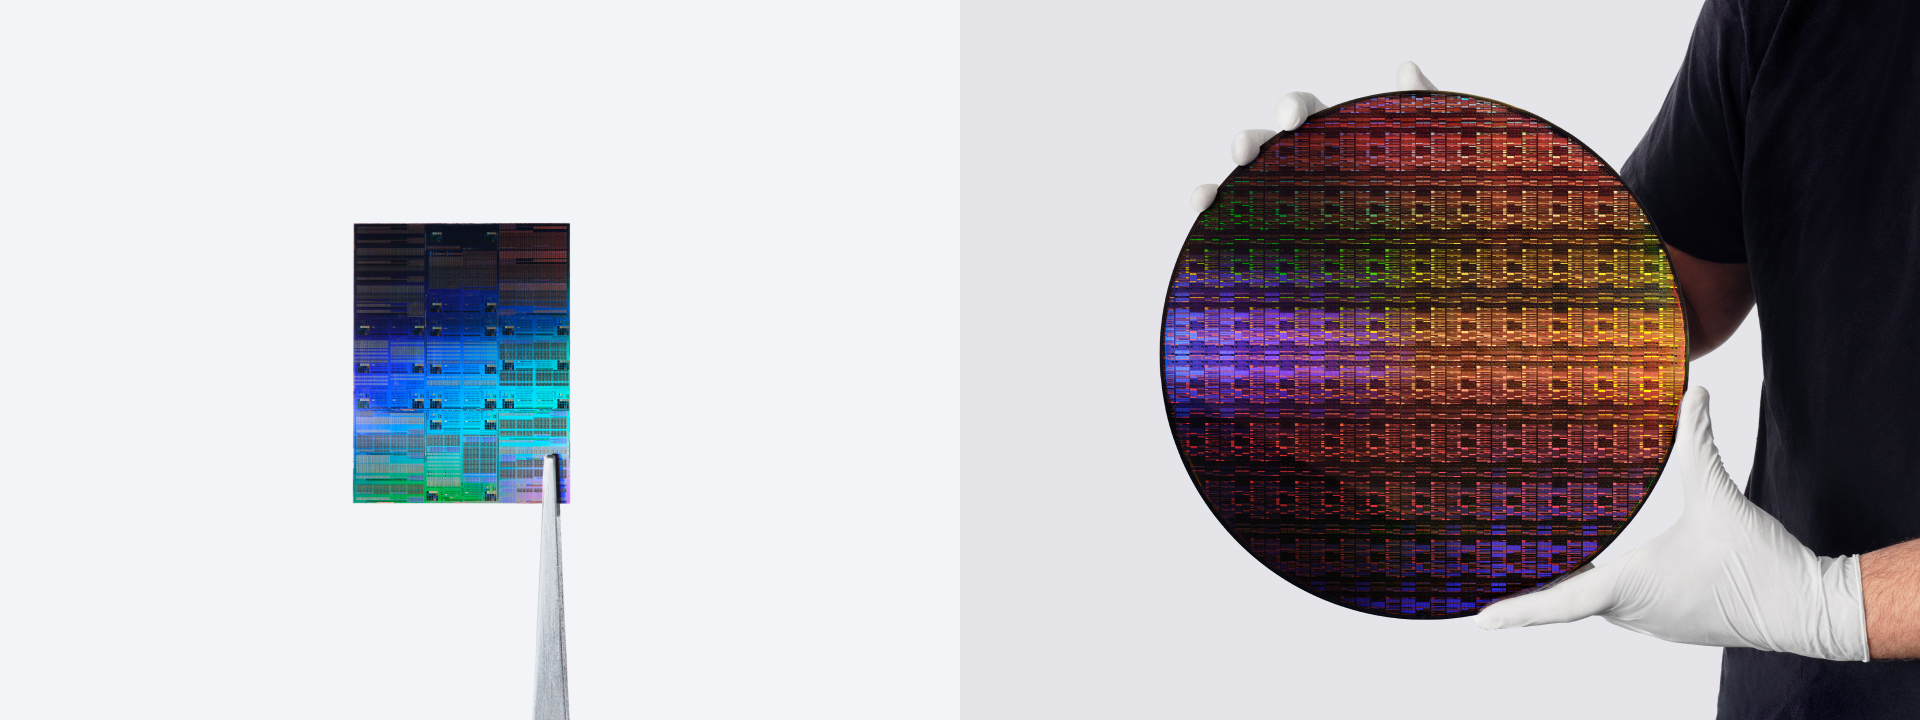
IBM ouvre une nouvelle phase avec sa gravure 0,7 nanomètre Nanostack, en préparant les kits de développement destinés aux fabricants de puces. L’annonce met le cap sur la densité, la consommation et la mémoire embarquée. Une échéance est désormais annoncée pour tester cette technologie.
IBM avance vers la gravure 0,7 nanomètre et prépare les fabricants à l’adoption
Le groupe informatique a franchi une étape décisive autour de son procédé Nanostack. Présentée en juin, cette gravure cherche à améliorer la densité de transistors, la performance, l’efficacité énergétique et la miniaturisation des puces mémoire.
La technologie 0,7 nanomètre prolonge les nœuds de production actuels, avec le 2 nm en production de masse. Après cette génération, Intel et TSMC prévoient des processus 18A, A16 et A14. Dans cette notation, un nanomètre correspond à dix angströms.
Le 0,7 nm, soit sept angströms en notation marketing, vise des gains en densité de transistors, en performance, en consommation et en réduction des cellules SRAM.

IBM précise que les kits de développement de processus (PDK) seront mis à disposition au premier trimestre 2027 pour les partenaires intéressés. Ces outils permettent aux fabricants de puces, comme NVIDIA et AMD, de concevoir leurs produits à partir de règles, de vérificateurs et de scripts destinés aux outils de conception électronique (EDA) fournis par Cadence et Synopsys.
Les concepteurs pourront évaluer la gravure Nanostack dès l’ouverture des kits. Cette architecture empile verticalement les transistors, puis les décale, afin d’optimiser les éléments n et p.
Dans un semi-conducteur, les transistors n sont issus d’un dopage du silicium apportant un électron libre, tandis que les transistors p reposent sur une vacance électronique. Leur association évite une charge statique quand la puce reste inactive.
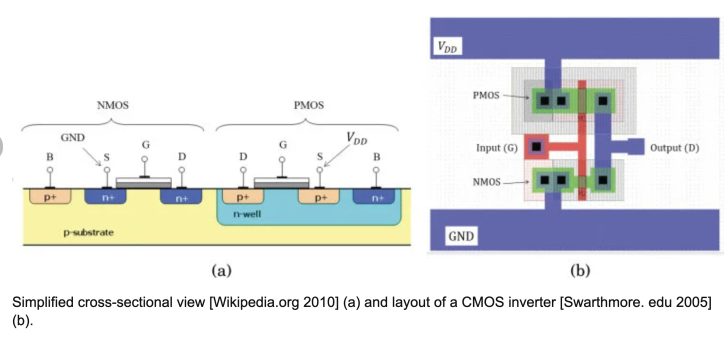
L’empilement séquentiel des transistors n et p doit libérer de la surface et permettre une optimisation plus fine. Comme chaque type exige des matériaux de dopage différents, leur séparation ouvre la porte à de nouvelles expériences sur les couches actives.
Côté mémoire, la gravure à sept angströms vise une réduction de 40% des cellules SRAM. Pour les puces logiques, le passage au 2 nm aide encore à réduire la taille des transistors et à améliorer la performance et l’efficacité énergétique. En dessous de trois nanomètres, la SRAM subit des fuites de courant, des pertes de puissance et des difficultés de propagation du signal.
Dans un bloc SRAM, des variations microscopiques de dopants et de rugosité des lignes peuvent fortement affecter la performance. Tandis que les composants logiques, y compris les GPU, ont profité des transitions de nœud, la mémoire embarquée est restée plus figée. Les puces dédiées à l’intelligence artificielle dépendent de la SRAM pour leurs caches, ce qui lui laisse souvent une part importante de la surface totale.
Pour la puce d’intelligence artificielle Hopper H100 de NVIDIA, la SRAM est estimée autour de 10% de la surface de la puce. Avec le cache L1 présent dans les unités de calcul SM, la part monte entre 12% et 15%, proche de l’espace occupé par la mémoire haute bande passante (HBM).