Microsoft dévoile RDMA sur USB4 pour Windows 11
Microsoft vient d’annoncer une fonctionnalité inédite pour Windows 11, capable de transformer un groupe d’ordinateurs personnels en un véritable cluster de calcul pour l’IA. Cette technologie, baptisée RDMA over USB4, permet à plusieurs PC de combiner leur mémoire vive et la puissance de leurs GPU via une simple connexion USB4. L’objectif est clair : exécuter localement des modèles d’intelligence artificielle massifs qui dépasseraient les capacités d’une seule machine, et ce sans matériel réseau spécialisé.
Une percée pour le calcul distribué grand public
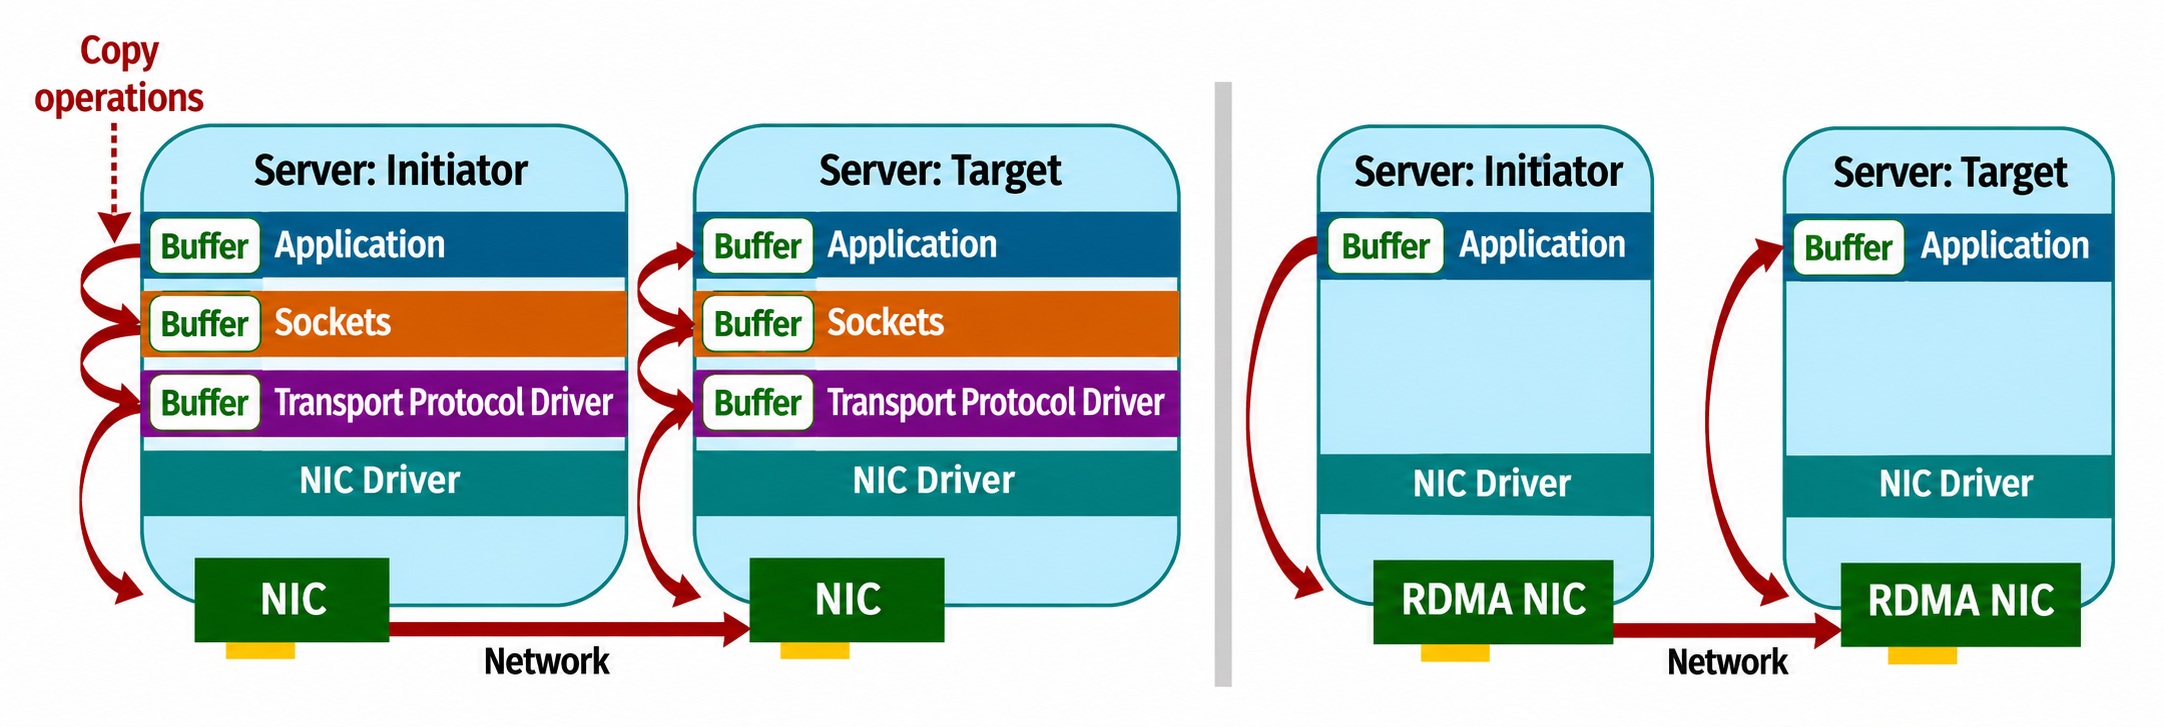
Microsoft a dévoilé un nouvel ajout à Windows 11 permettant de fusionner les ressources de plusieurs PC via USB4. Cette fonction, appelée RDMA over USB4, repose sur l’accès direct à la mémoire à distance. Elle autorise le transfert de données directement entre la mémoire des systèmes connectés, en contournant une grande partie des couches logicielles réseau classiques. Traditionnellement réservée aux serveurs et datacenters, cette approche réduit considérablement la latence et la surcharge de communication.
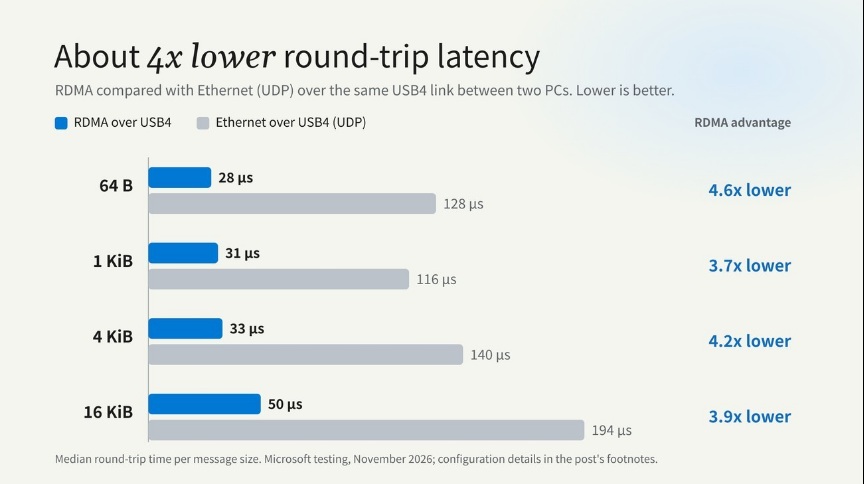
Dans ses mesures, Microsoft rapporte que le RDMA sur USB4 a permis d’obtenir des latences aller-retour d’environ 28 à 50 microsecondes pour de petits messages. C’est une réduction d’environ 4 fois par rapport à une communication Ethernet classique sur USB4 utilisant le protocole UDP. Cette faible latence a été maintenue aussi bien sur des connexions à 40 Gbps qu’à 80 Gbps, cette dernière offrant bien sûr une bande passante nominale doublée.
AMD et Intel démontrent des capacités impressionnantes
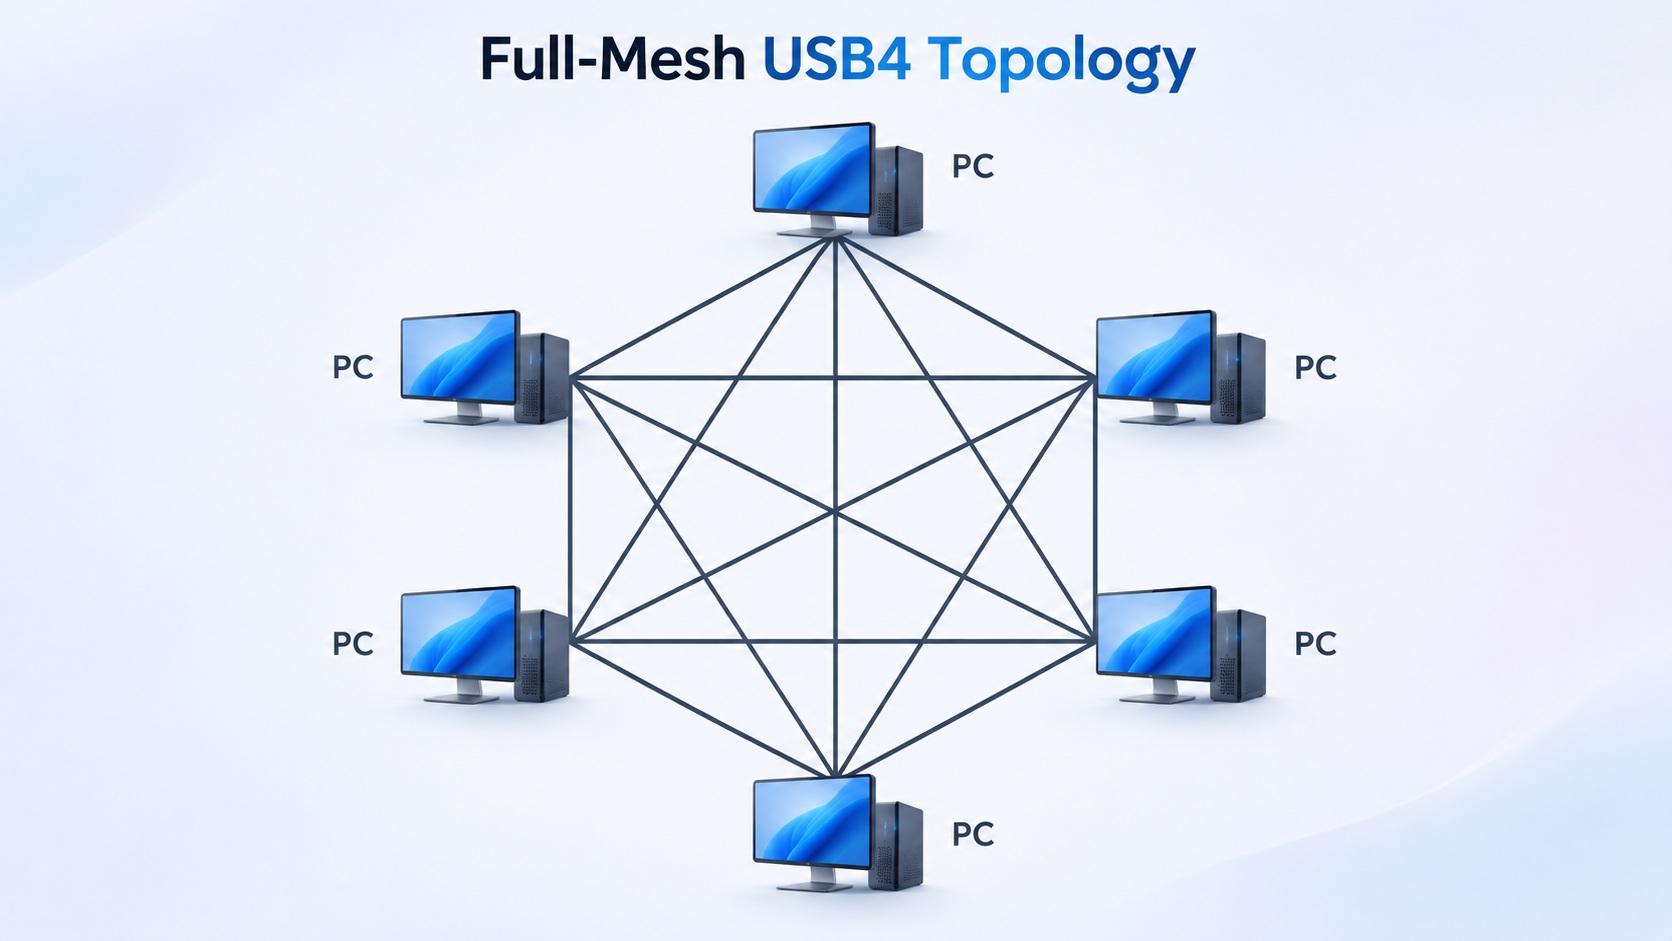
En collaboration avec AMD, Microsoft a présenté une démo avec trois mini-PC équipés chacun d’un processeur Ryzen AI Max+ 395, d’une carte graphique Radeon 8060S et de 128 Go de mémoire unifiée. Connectés en maillage complet via USB4 40 Gbps, ces systèmes ont exécuté le modèle à architecture mixte Qwen3-235B-A22B, qui comporte 235 milliards de paramètres. La vitesse d’inférence atteignait environ 18,5 tokens par seconde avec une quantification sur 4 bits. De son côté, AMD a mesuré des résultats encore meilleurs, jusqu’à 21,98 tokens/s lors du décodage.
Intel a également démontré la technologie en utilisant trois puis quatre PC basés sur des processeurs Core Ultra Series 3, avec 64 Go de mémoire et une connectivité Thunderbolt 4. Avec le modèle GPT-OSS-120B, Intel a enregistré environ 49,4 tokens/s avec trois PC, passant à 54,2 tokens/s avec quatre systèmes. Ces performances sont remarquables car ce modèle de 120 milliards de paramètres ne peut pas tenir dans la mémoire d’une seule machine de 64 Go.
Une technologie expérimentale aux conditions strictes
Cette innovation reste expérimentale et nécessite des configurations matérielles et logicielles spécifiques. Les PC participants doivent disposer de connexions USB4 gérées par Windows, idéalement à 40 Gbps ou plus. Microsoft recommande également une topologie en maillage complet, où chaque machine est directement connectée à toutes les autres, plutôt qu’en chaîne, pour éviter une dégradation des performances.
De plus, les applications doivent explicitement prendre en charge l’exécution distribuée via des frameworks compatibles. Microsoft a déjà publié un fournisseur NetworkDirect open source et une version modifiée de llama.cpp pour illustrer le concept.
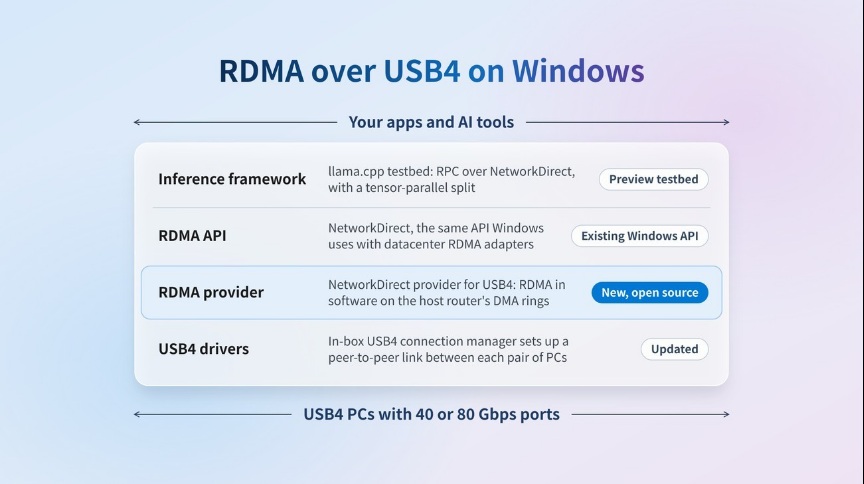
La fonctionnalité devrait arriver dans une future build du canal Windows Insider Experimental Channel (Future Platforms), mais Microsoft n’a pas communiqué de date de sortie précise. Cette préversion sera désactivée par défaut et nécessitera une configuration via le Registre ainsi que l’activation du mode test de signature, ce qui implique temporairement de désactiver le Secure Boot. L’éditeur recommande donc de l’essayer sur des machines de développement dédiées, et non sur des PC d’usage quotidien.
Si sa disponibilité générale reste incertaine, cette technologie pourrait à terme rendre l’inférence IA locale puissante bien plus accessible, permettant aux développeurs de répartir la charge de travail sur plusieurs PC existants au lieu d’investir dans des serveurs IA dédiés et coûteux.
Source : Microsoft