Thinking Machines : son IA Inkling 2 Mini tourne localement sur MacBook avec 32 Go de RAM
Thinking Machines Lab vient de présenter son nouveau modèle d’intelligence artificielle, Inkling 2 Mini. Cette version ouverte affiche seulement 26 milliards de paramètres mais se montre très performante en programmation et en raisonnement. Le plus remarquable : il peut tourner localement sur du matériel grand public, comme un MacBook doté de 32 Go de mémoire unifiée.
Une architecture astucieuse pour un raisonnement renforcé
Thinking Machines a dévoilé le Inkling 2 Mini le 20 novembre. Ce modèle ouvert se présente comme une alternative bien plus compacte au colossal Inkling 2 Small de 594 milliards de paramètres. L’entreprise a adopté une approche architecturale originale pour renforcer les capacités de raisonnement sans simplement réduire une structure existante.
Les résultats sont convaincants, avec un score de 20,1 à l’Artificial Analysis Intelligence Index et des performances qui rivalisent avec des modèles d’IA bien plus grands.
Un transformateur à boucle pour plus de puissance de calcul
Selon l’annonce technique officielle, Inkling 2 Mini repose sur une architecture de transformateur Mixture of Experts à 24 couches. Il totalise 26,4 milliards de paramètres, mais seulement 3,4 milliards sont actifs à un instant donné.
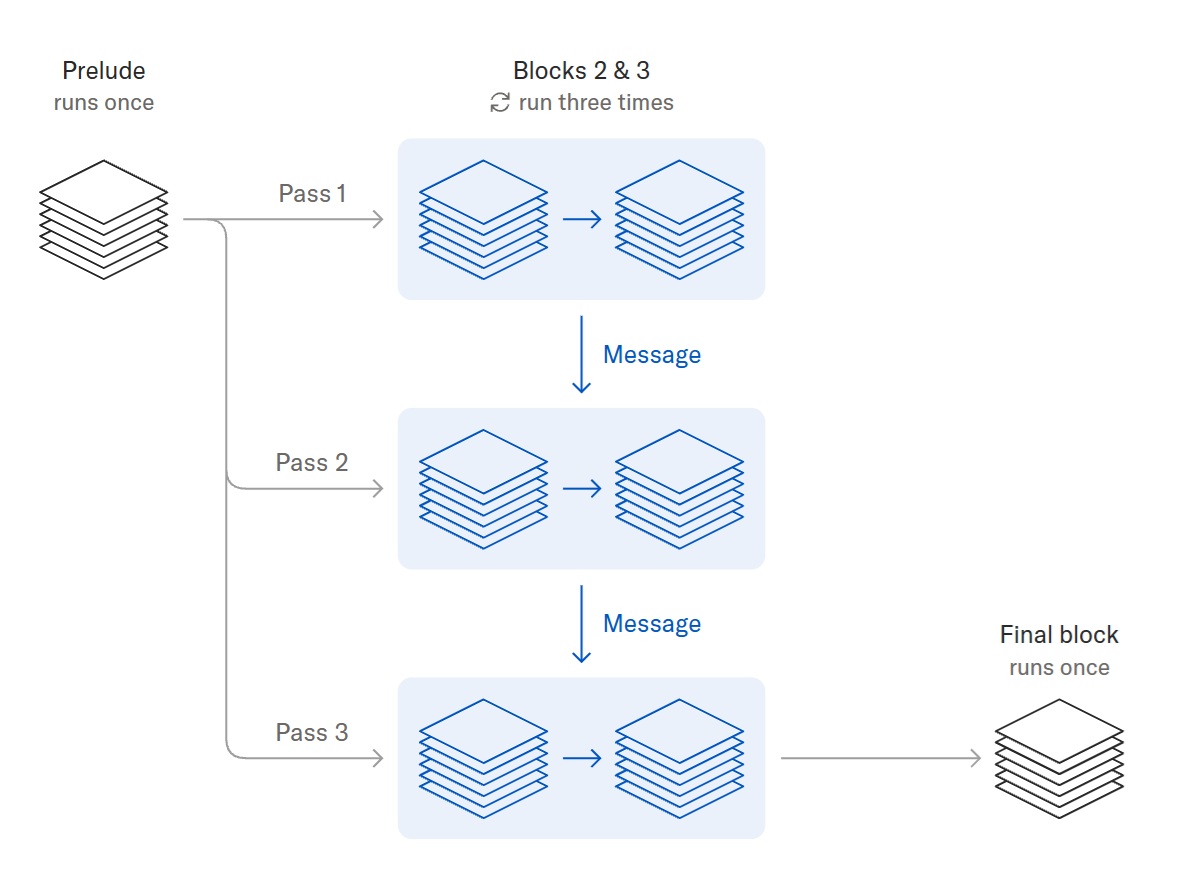
La particularité réside dans son traitement de l’information. Au lieu de faire passer chaque token une seule fois par toutes les couches, les 12 couches centrales sont exécutées trois fois, tandis que les six premières et les six dernières fonctionnent normalement.
En conséquence, le modèle applique 48 couches par token tout en ne stockant les poids que pour 24 couches. Cela augmente son nombre de paramètres actifs effectifs à 5,4 milliards par token, autorisant un calcul supplémentaire sans alourdir proportionnellement les besoins en mémoire.
Plus simplement, Inkling 2 Mini peut passer plus de temps à raisonner en interne avant de produire son token suivant.
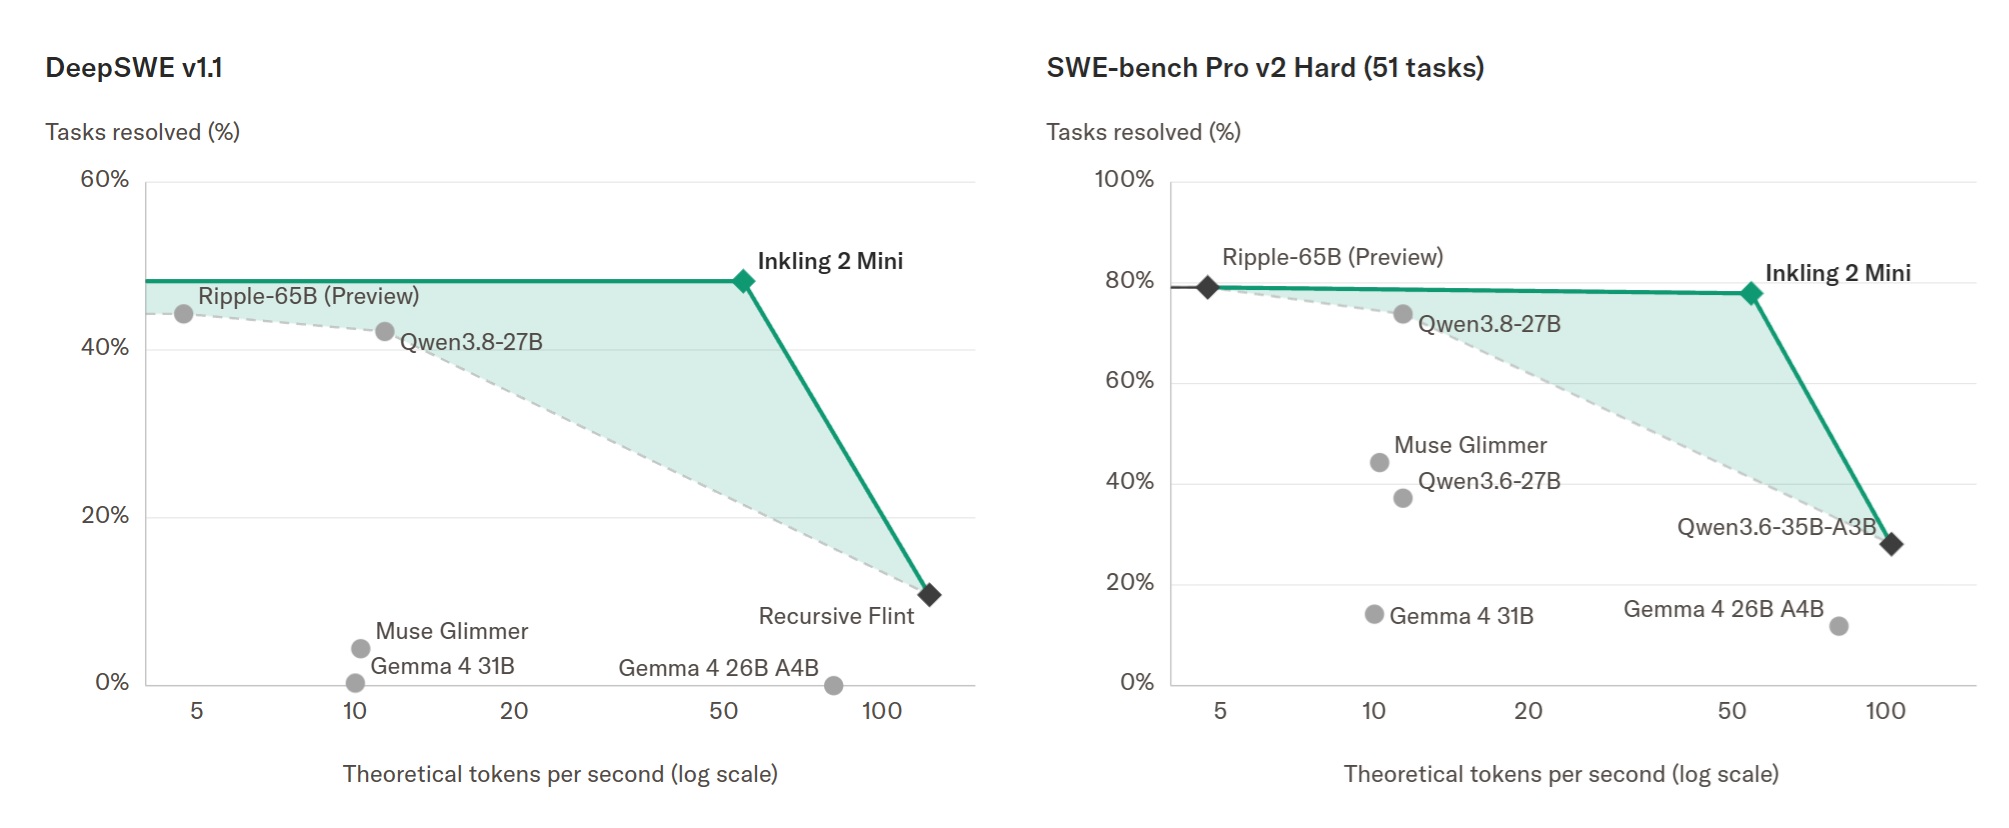
L’entreprise affirme que cette méthode apporte des améliorations notables en programmation agentique. Inkling 2 Mini a obtenu 48,2% sur DeepSWE v1.1, contre 42,2% pour le Qwen3.8-27B. Son score sur SWE-bench Pro v2 Hard atteint 77,9%, surpassant les 73,8% du modèle concurrent.
Il marque également 46,5% sur le Vals Index v2.2 et 79,2% sur SWE-bench Verified. Ce sont des résultats d’évaluation rapportés par la société ; les différences de configuration de test empêchent de les voir comme des avantages universels.
Thinking Machines a entraîné ce modèle sur la plateforme NVIDIA GB300 Grace Blackwell Ultra, exploitant les capacités matérielles NVFP4 pour améliorer l’efficacité. La plupart des poids ont été entraînés en précision NVFP4 4 bits, les quatre dernières couches utilisant la précision MXFP8 8 bits. Les poids étant déployés dans la même précision que leur entraînement, le modèle éviterait les pertes associées à une quantification post-entraînement.
Accessible localement sur Mac et PC
L’aspect le plus excitant d’Inkling 2 Mini est son accessibilité. Avec une empreinte mémoire d’environ 20 Go, il peut fonctionner sur Mac à puce Apple dotés d’au moins 32 Go de mémoire unifiée via Ollama.
L’ordinateur de bureau NVIDIA DGX Spark est aussi officiellement supporté. D’autres configurations avec carte graphique sont possibles, 32 Go ou plus de VRAM étant recommandés. Le modèle accepte les entrées texte et image, avec une fenêtre de contexte pouvant atteindre un million de tokens.
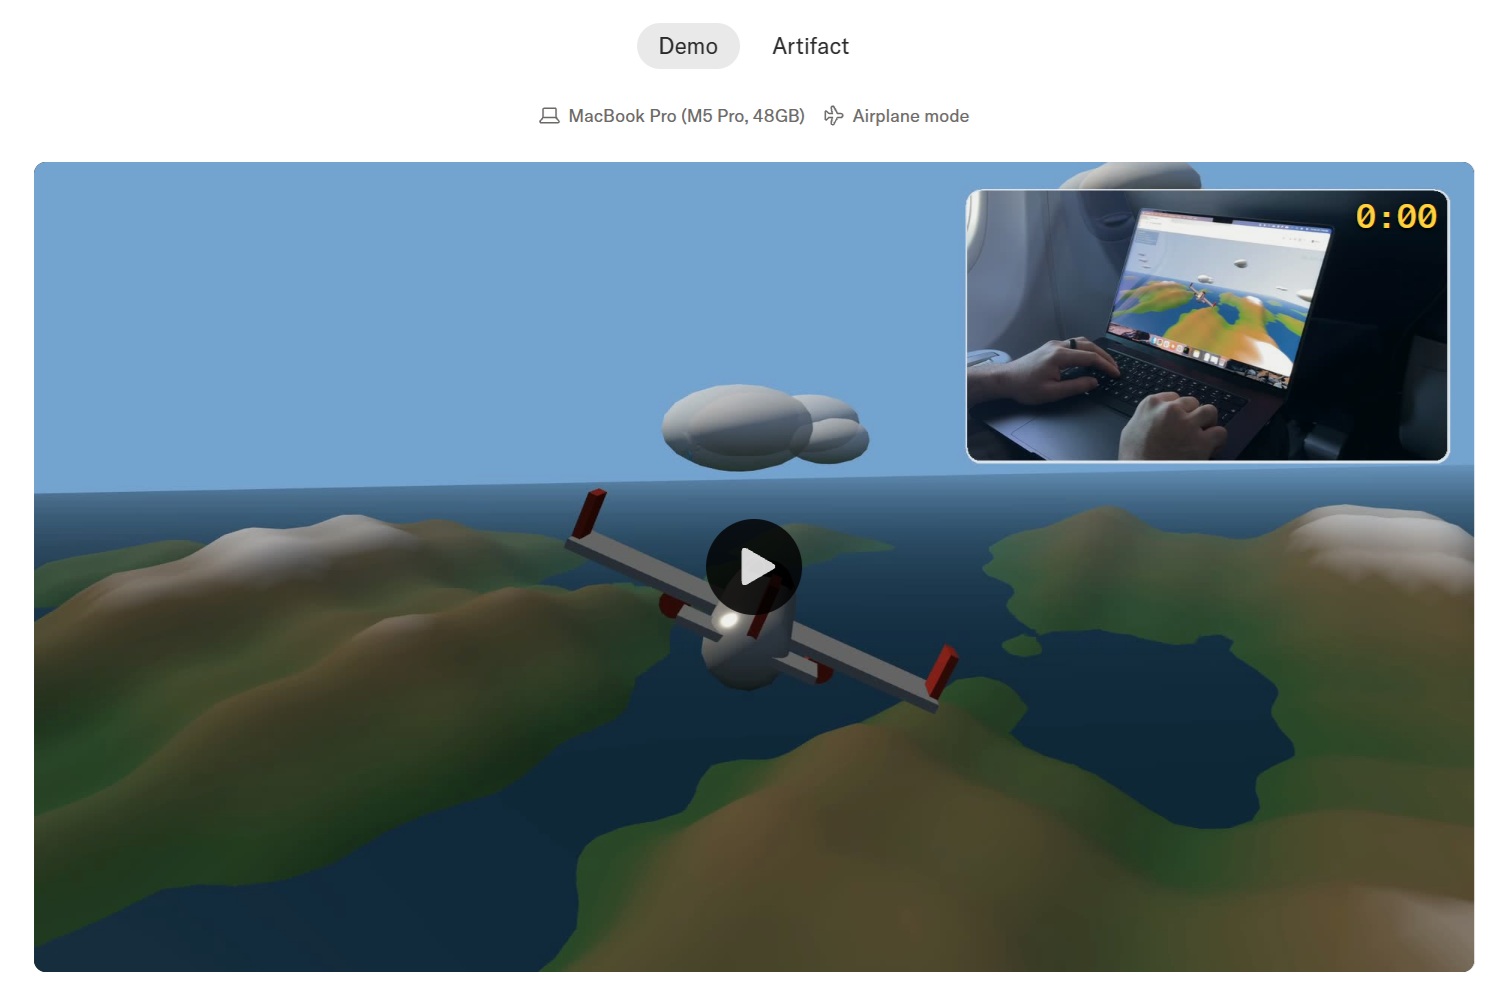
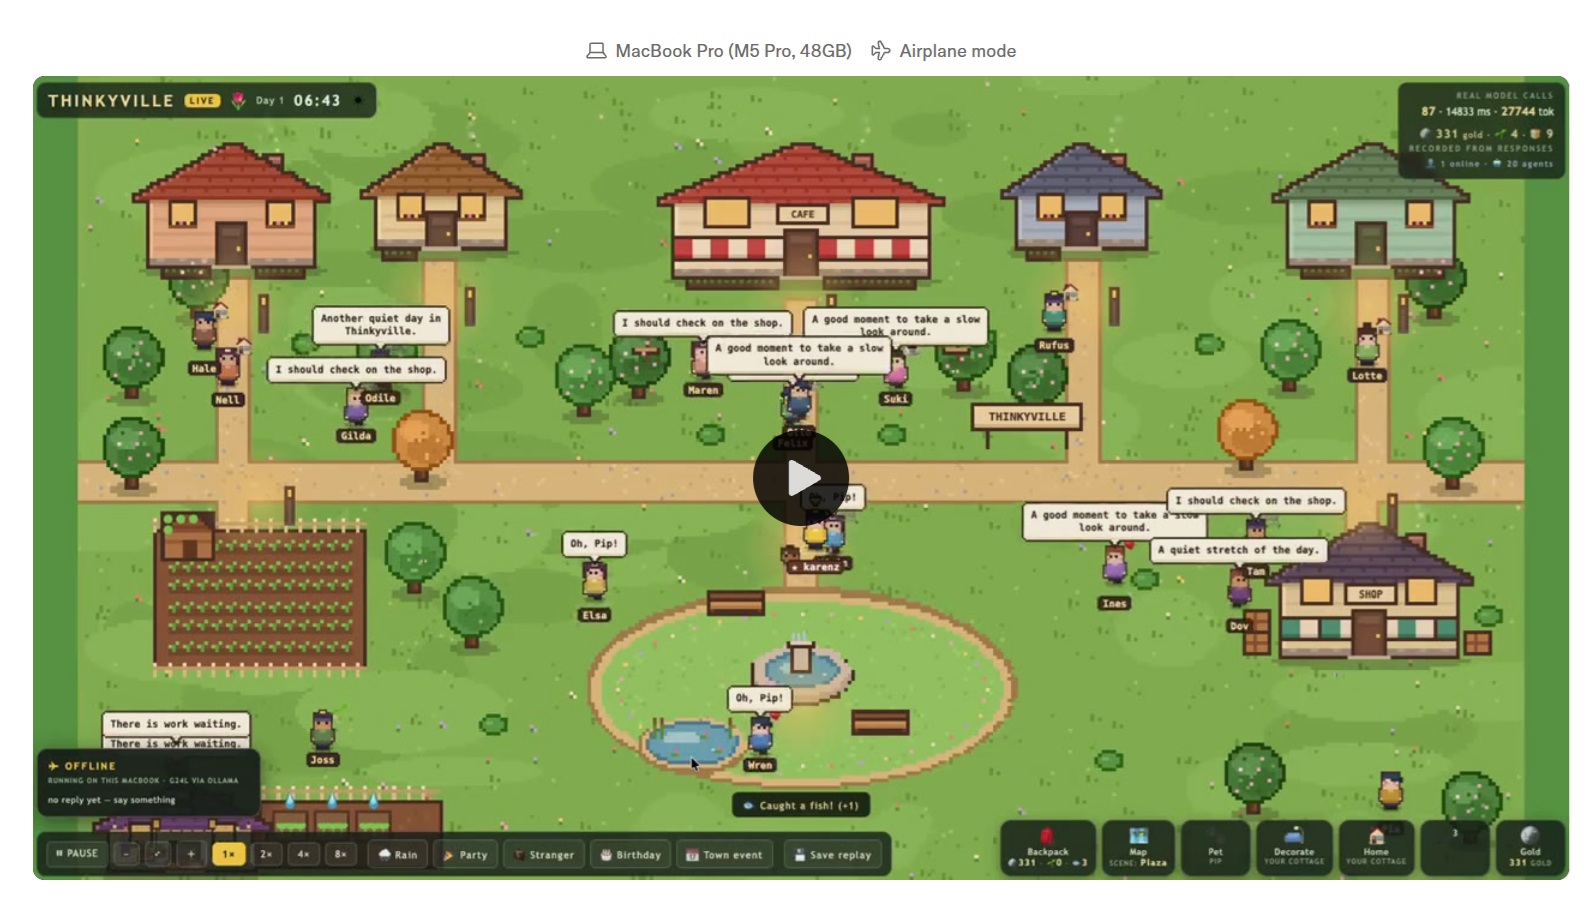
Pour démontrer ses capacités, Thinking Machines a montré Inkling 2 Mini fonctionnant hors ligne sur un MacBook Pro M5 Pro avec 48 Go de mémoire. Durant un vol, le modèle aurait généré un simulateur de vol jouable en quelques minutes.
Transparence et limites
Cette architecture soulève toutefois des questions sur la transparence de l’IA. Puisque les transformateurs à boucle peuvent effectuer des calculs internes supplémentaires sans écrire explicitement chaque étape de raisonnement, certains chercheurs s’inquiètent d’une surveillance plus difficile.
Thinking Machines a étudié ce point avec un modèle de recherche à boucle variable. Ils ont découvert que des passes additionnelles augmentaient la capacité du modèle à résoudre des problèmes sans produire de chaîne de pensée écrite. Son horizon de tâche sans chaîne de pensée est passé de 16 secondes avec une passe à 37 secondes avec trois.
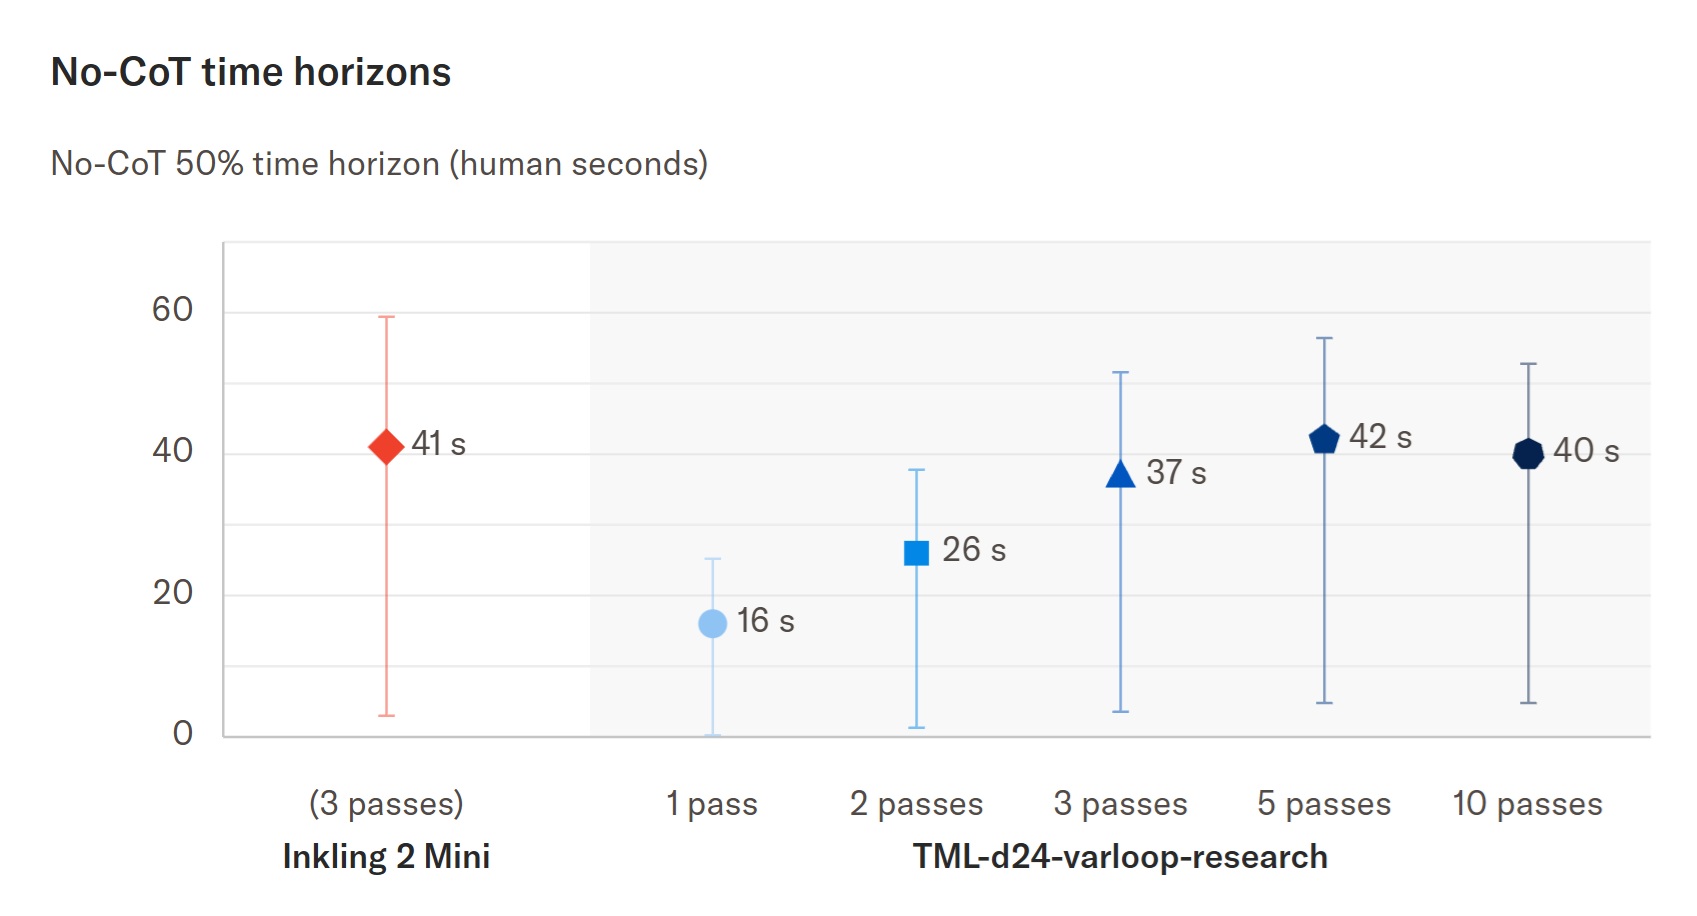
Les expériences de l’entreprise ont néanmoins montré que le raisonnement écrit du modèle restait compréhensible, sans réduction significative de la surveillabilité à cette échelle. Les chercheurs reconnaissent aussi des limites, comme des performances plus faibles sur des conversations multitours complexes ou des instructions avec de nombreuses contraintes.
Inkling 2 Mini est désormais disponible sous licence Apache 2.0. Ses poids sont téléchargeables sur Hugging Face, son déploiement local se fait via Ollama, et l’inférence et le fine-tuning sont possibles sur la plateforme Tinker de Thinking Machines.
Pour les développeurs souhaitant exécuter des agents d’IA performants localement plutôt que de dépendre exclusivement de l’infrastructure cloud, Inkling 2 Mini constitue une avancée intéressante vers une IA avancée plus accessible.
Source : Thinking Machines