Un LLM 120B s’exécute sur un téléphone, trois Macs et deux PC Windows
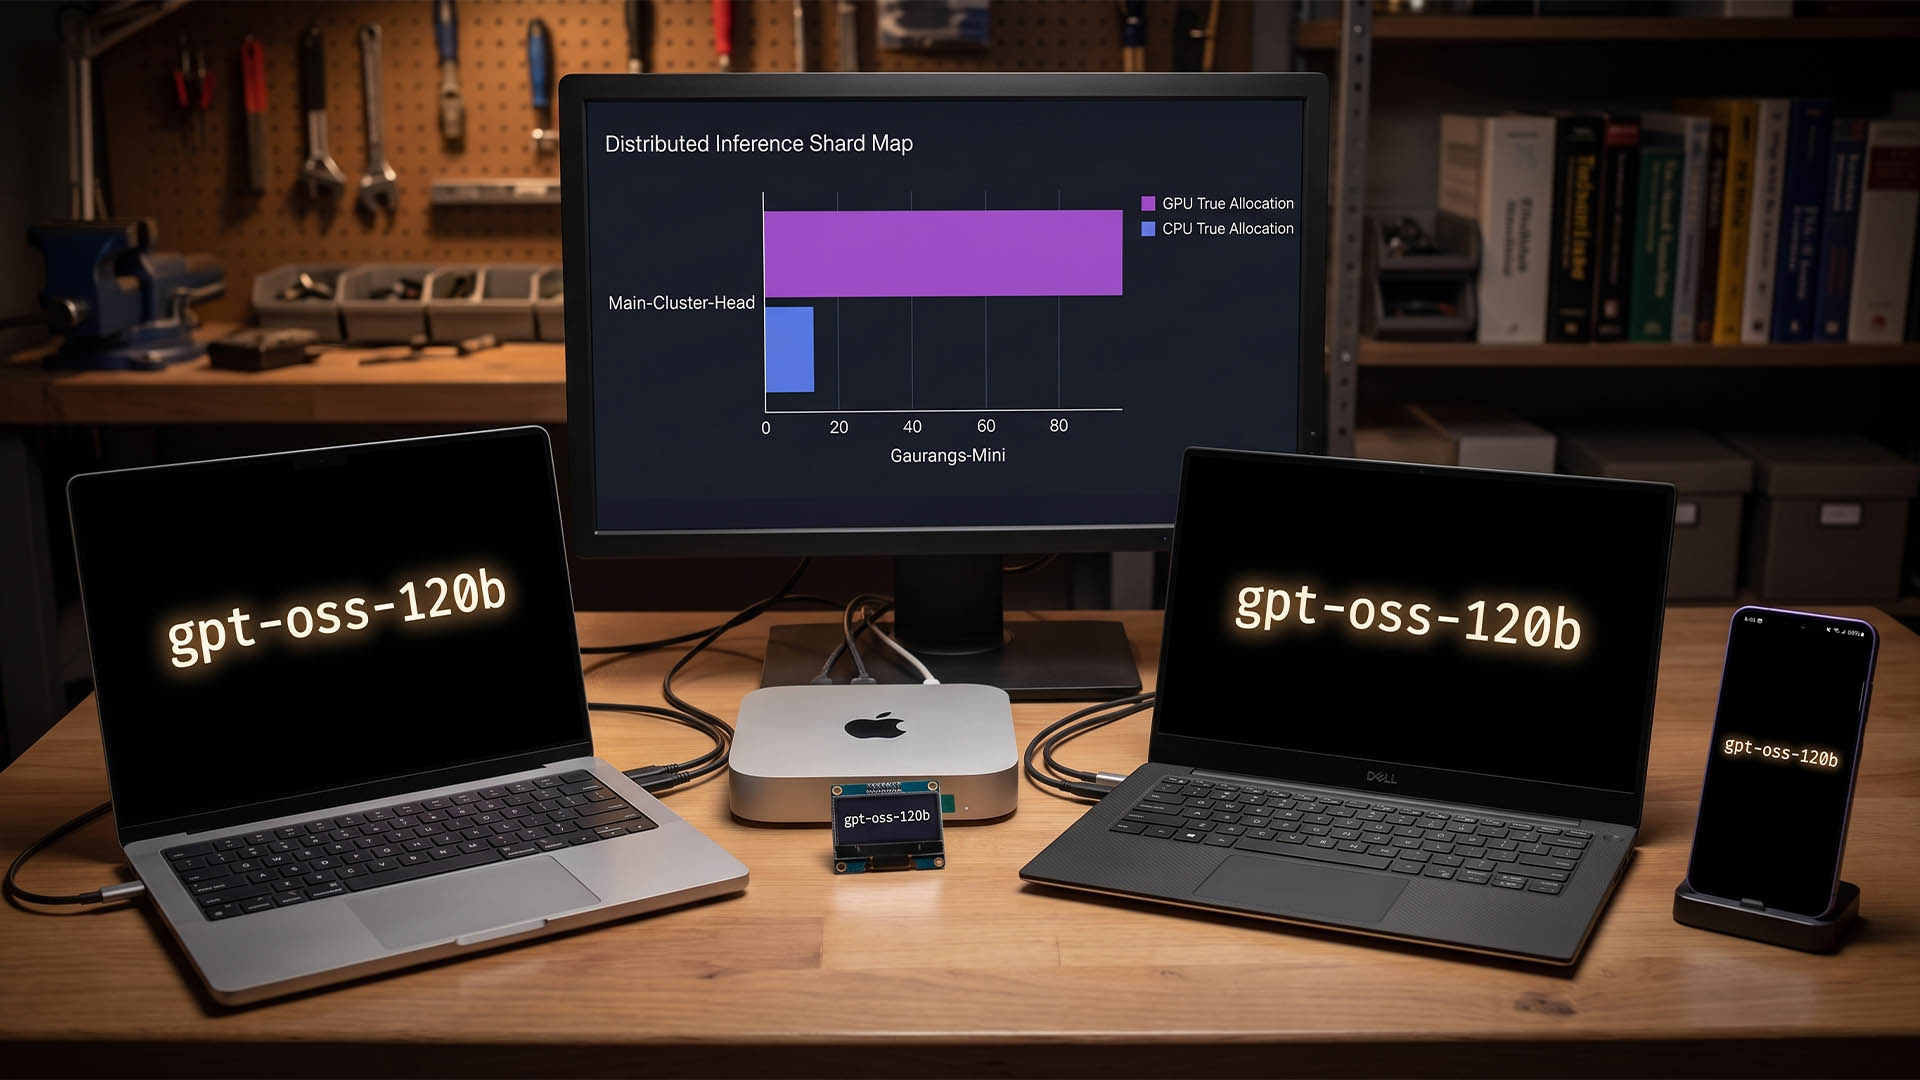
Faire tourner un modèle de langage géant comme gpt-oss-120b nécessite généralement des dizaines de gigaoctets de mémoire dédiée et un matériel très onéreux. Un utilisateur a pourtant réussi cet exploit en fédérant plusieurs appareils grand public, dont un smartphone Android. Son projet démontre une approche ingénieuse, bien que peu pratique pour un usage réel.
Une prouesse technique aux limites évidentes
Pour faire fonctionner un modèle de 120 milliards de paramètres comme gpt-oss-120b, il faut au minimum entre 60 et 80 Go de mémoire combinée (VRAM et RAM système). Un passionné a contourné cette contrainte en utilisant un assemblage hétéroclite : un Galaxy S24+, un mini-PC équipé d’une RTX 3060 (12 Go de VRAM), un portable Windows avec 12 Go de RAM, et plusieurs Mac (dont un MacBook Pro M3). La version exécutée est quantifiée sur 4 bits, ce qui réduit son empreinte mémoire à 60 Go. La version non quantifiée nécessiterait, elle, 240 Go de RAM, un chiffre hors de portée pour la quasi-totalité des configurations personnelles.
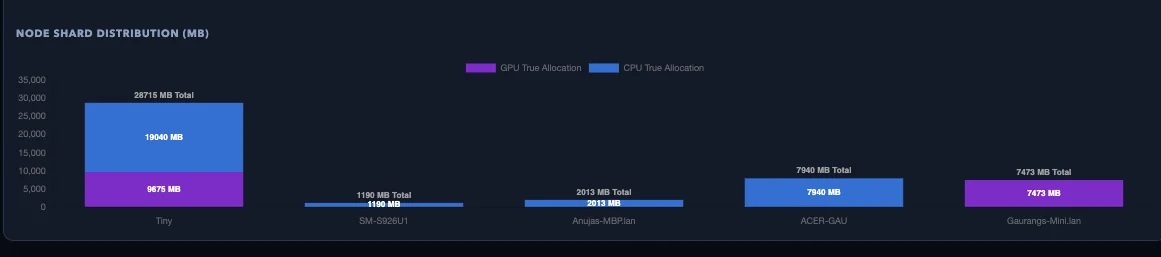
L’astuce repose sur deux principes. Premièrement, l’empreinte mémoire totale a été ramenée à 47 Go. Deuxièmement, un logiciel exploitant le « parallelisme par pipeline » a été employé. Cette technique permet de répartir les différentes couches du modèle d’IA sur chacun des appareils connectés en réseau, plutôt que de charger l’intégralité du modèle sur une seule machine.
La charge de travail a ainsi été divisée. L’ordinateur principal, surnommé « Tiny », a supporté la majeure partie du calcul avec 28,7 Go de mémoire système et la GPU RTX 3060. Actuellement, exécuter de tels modèles avec 128 Go de mémoire unifiée n’est possible que sur des machines haut de gamme, comme les MacBook Pro les plus chers ou les futurs portables équipés de RTX Spark.
Cette expérience prouve qu’il est possible de faire tourner des modèles massifs sur du matériel modeste, mais le compromis sur les performances est colossal. Le cluster entier ne produit qu’environ 1,1 jeton par seconde, une vitesse délibérément lente. Cette approche reste donc anecdotique et peu viable pour qui souhaite une productivité réelle sans connexion internet.
Si une patience à toute épreuve fait partie de vos qualités, vous pourriez tenter l’aventure. Sinon, se tourner vers des modèles moins denses reste la solution la plus raisonnable.