NVIDIA DSX MaxLPS : +40% de tokens par mégawatt, le cluster Lambda à 5M/s
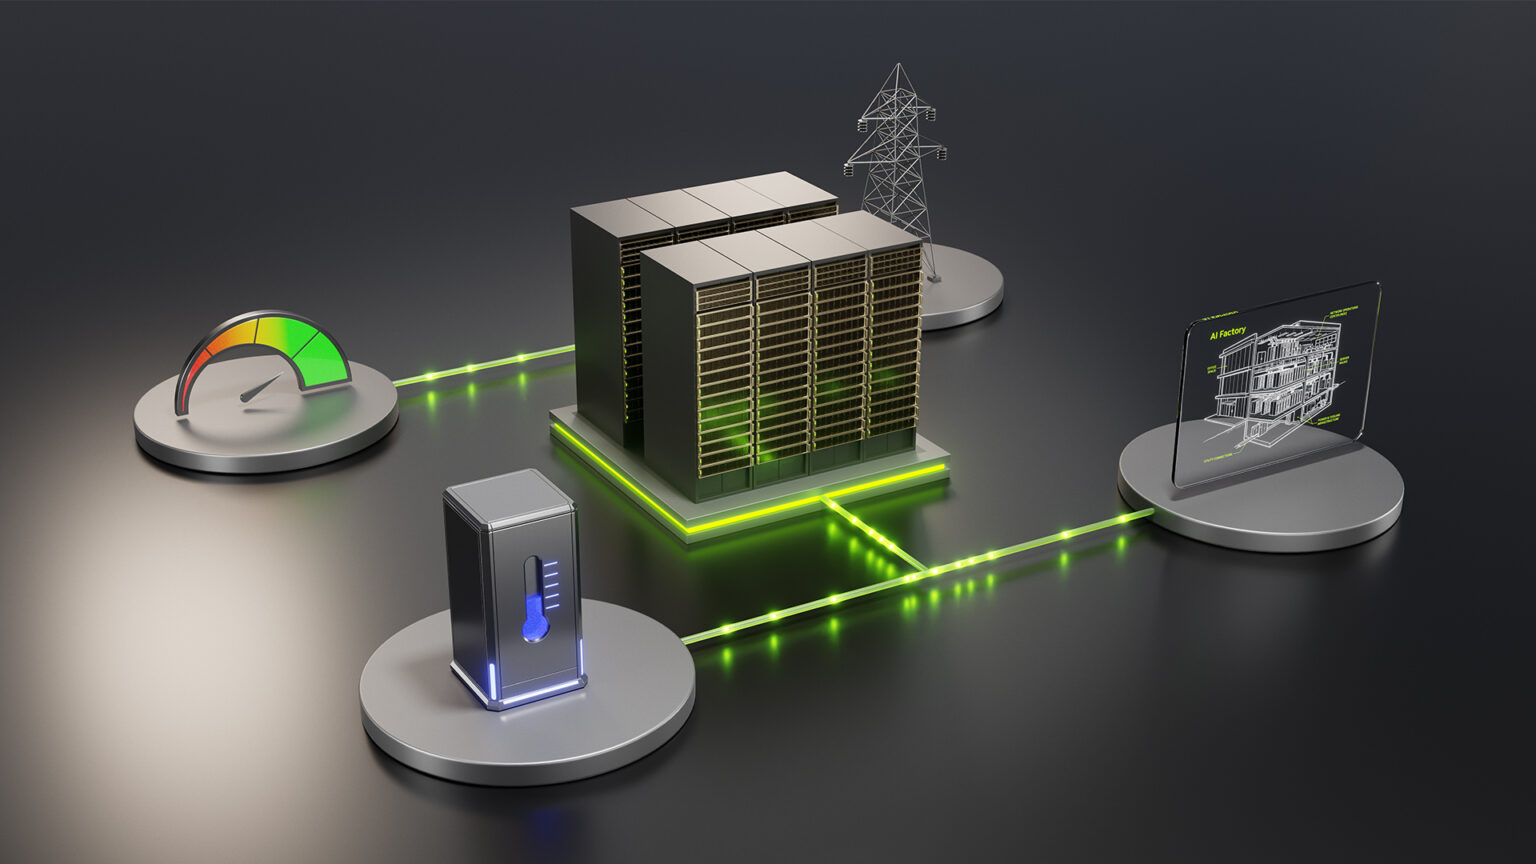
NVIDIA a récemment mis en lumière ses dernières optimisations pour l’efficacité énergétique, dévoilées lors du AI Infra Summit. Ces améliorations, intégrées aux futures plateformes Vera Rubin, visent à augmenter significativement le débit de traitement des tokens, un enjeu majeur face à la demande exponentielle en IA.
Les gains d’efficacité énergétique de NVIDIA pour Vera Rubin
La demande en calcul pour l’intelligence artificielle exerce une pression considérable sur les infrastructures électriques. Pour y répondre, NVIDIA développe une palette de solutions à travers sa plateforme complète d’usines d’IA. Celle-ci englobe les systèmes Vera Rubin, le logiciel d’inférence Dynamo, les bibliothèques NeMo et diverses solutions réseau comme NVLink, Spectrum-X et les SuperNICs ConnectX.
Afin de garantir le meilleur débit de tokens possible, la technologie DSX MaxLPS de NVIDIA permet d’atteindre jusqu’à 40% de tokens en plus par mégawatt. Emerald AI utilise déjà DSX dans sa plateforme Conductor, illustrant ainsi les capacités d’orchestration du réseau électrique offertes par cet outil.
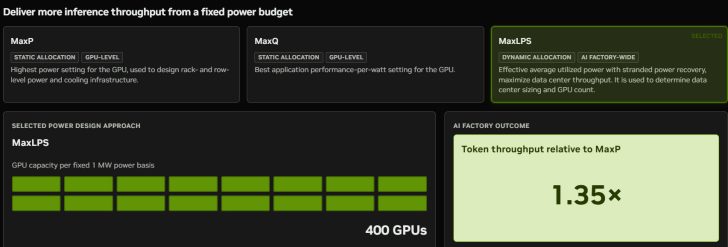
Avec DSX Flex, la plateforme Conductor ajuste dynamiquement la consommation énergétique du centre de données en fonction de l’état du réseau électrique. L’objectif est de réduire la demande en électricité lors des périodes de forte contrainte sur le réseau, tout en préservant la continuité des charges de travail d’IA critiques.
Jusqu’à présent, l’usine a traité 200 signaux basés sur l’état du réseau, chaque fois avec succès et sans intervention manuelle. Par ailleurs, des fournisseurs de cloud comme Lambda ont testé la plateforme et observé un débit de tokens supérieur de 24% pour un budget énergétique fixe.
Lambda, un fournisseur de cloud GPU desservant plus de 10 000 clients, a exécuté le logiciel sur un cluster de 19 nœuds répartis sur cinq baies.
Leur découverte : en faisant fonctionner 19 nœuds avec le même budget énergétique que 16 nœuds à pleine puissance, Lambda a obtenu 24% de débit de tokens en plus à l’échelle du cluster, passant d’environ 4 à 5 millions de tokens par seconde. Les performances par watt se sont améliorées de 23%.
Ces avantages se traduisent par un meilleur débit de tokens sur les baies Vera Rubin et Groq 3 LPX :
- Jusqu’à 40% de GPU en plus pour la même enveloppe de puissance sur site.
- Jusqu’à 35% de débit de tokens supérieur, sans nécessiter de nouvelles lignes électriques.
Les chiffres parlent d’eux-mêmes. Sur une charge de travail Qwen 3.8 27B avec un contexte de 100K, le Groq 3 LPX a atteint 2 529 tokens de sortie par seconde et par utilisateur. Cette marge permet aux agents d’exécuter plus d’étapes de raisonnement et d’appels d’outils dans le même budget de réponse, même à grande échelle.
Des startups du monde entier partagent également leurs premières impressions sur les CPU Vera de NVIDIA. Les résultats préliminaires de diverses entreprises d’IA montrent des gains allant jusqu’à 1,9x, des latences bien plus faibles, un débit supérieur de 73% et une multiplication par 3,3 du débit sur les tâches de requête par rapport à d’autres CPU.
Perplexity a testé le CPU Vera pour sa nouvelle plateforme de bac à sable sécurisé SPACE, montrant un démarrage 1,9 fois plus rapide.
Daytona l’a soumis à des charges de travail agentiques, signalant « des gains significatifs pour l’exécution agentique ».
ClickHouse a partagé des résultats sur ClickBench, son benchmark ouvert pour les bases de données analytiques. Le Vera est la machine la plus rapide mesurée par l’équipe à ce jour.
DeepInfra a exécuté plusieurs benchmarks sur le CPU Vera, qui a surpassé les autres sur toutes les métriques, avec une latence d’étape d’orchestration 2,2 fois plus rapide.
Prime Intellect a constaté que le CPU Vera maintenait une bande passante élevée et une faible latence mémoire constante malgré le parallélisme des charges de travail.
Redpanda a indiqué que son benchmark du CPU Vera affichait des latences 5,5 fois plus basses et un débit 73% supérieur à d’autres CPU.
Starburst a publié des résultats montrant un débit de requêtes 3 fois plus rapide avec le CPU Vera.
Kinetica a observé des performances de requêtes analytiques 2,7 fois plus rapides avec les CPU Vera.
NVIDIA et ses partenaires repensent les centres de données en usines d’IA co-conçues, mesurées non plus en FLOPS de pointe mais en tokens validés par mégawatt. Les exemples sont nombreux : les travaux NVHBM d’Annapurna, les intégrations NVLink Fusion de d-Matrix, le programme de charge flexible d’Emerald AI avec Silicon Valley Power, le gain de 23% en performance par watt de Lambda avec DSX MaxLPS, l’IA visuelle de Pinterest combinant Blackwell et Dynamo, ou encore le NVL72 Vera Rubin avec un débit AgentX multiplié par 30.
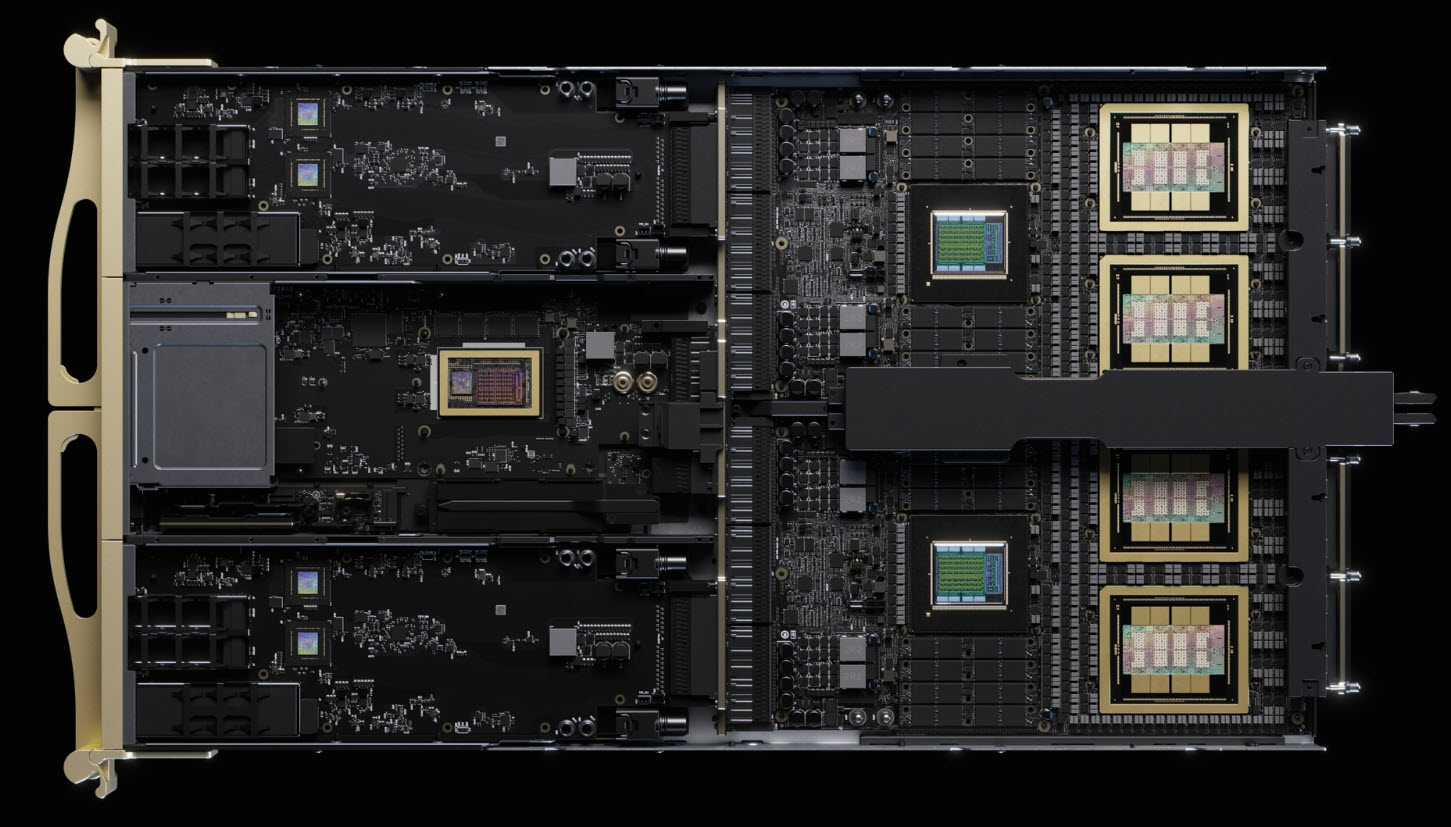
Le message est clair : des systèmes complets, du silicium au logiciel en passant par le réseau électrique, permettent d’extraire plus de tokens, de protéger les charges de travail prioritaires et d’optimiser chaque mégawatt. L’objectif est de transformer une puissance contrainte en une capacité accrue, un coût par token réduit et une plus grande valeur économique pour la prochaine génération d’infrastructures d’IA.