Huawei : ses futurs accélérateurs Ascend dopent l’inférence et la mémoire
Huawei a dévoilé sa nouvelle roadmap pour les accélérateurs d’IA Ascend et les SuperPods, avec plusieurs annonces majeures. La gamme de puces s’étend de l’Ascend 960DT au 980, promettant des gains significatifs en puissance de calcul et en bande passante mémoire. En parallèle, le système Atlas 960E SuperPod, le premier à intégrer l’optique NPO, vise à multiplier les performances des clusters d’entraînement et d’inférence.
Huawei accélère sa roadmap pour les accélérateurs d’IA
Lors de l’événement Huawei Connect 2026, l’entreprise a présenté sa stratégie pour les infrastructures d’intelligence artificielle. Pour répondre à la demande croissante, elle anticipe le lancement de quatre nouvelles puces Ascend et d’un système SuperPod révolutionnaire.
Le portefeuille des puces Ascend
La prochaine génération commencera avec l’Ascend 960DT, successeur de l’Ascend 950. Cette puce exploitera une nouvelle architecture SIMD/SIMT prenant en charge de nombreux formats de données, du FP32 au HiF4. Ses formats « H » permettent de remplacer deux formats de virgule flottante standard par un seul, optimisant la précision et la plage dynamique.
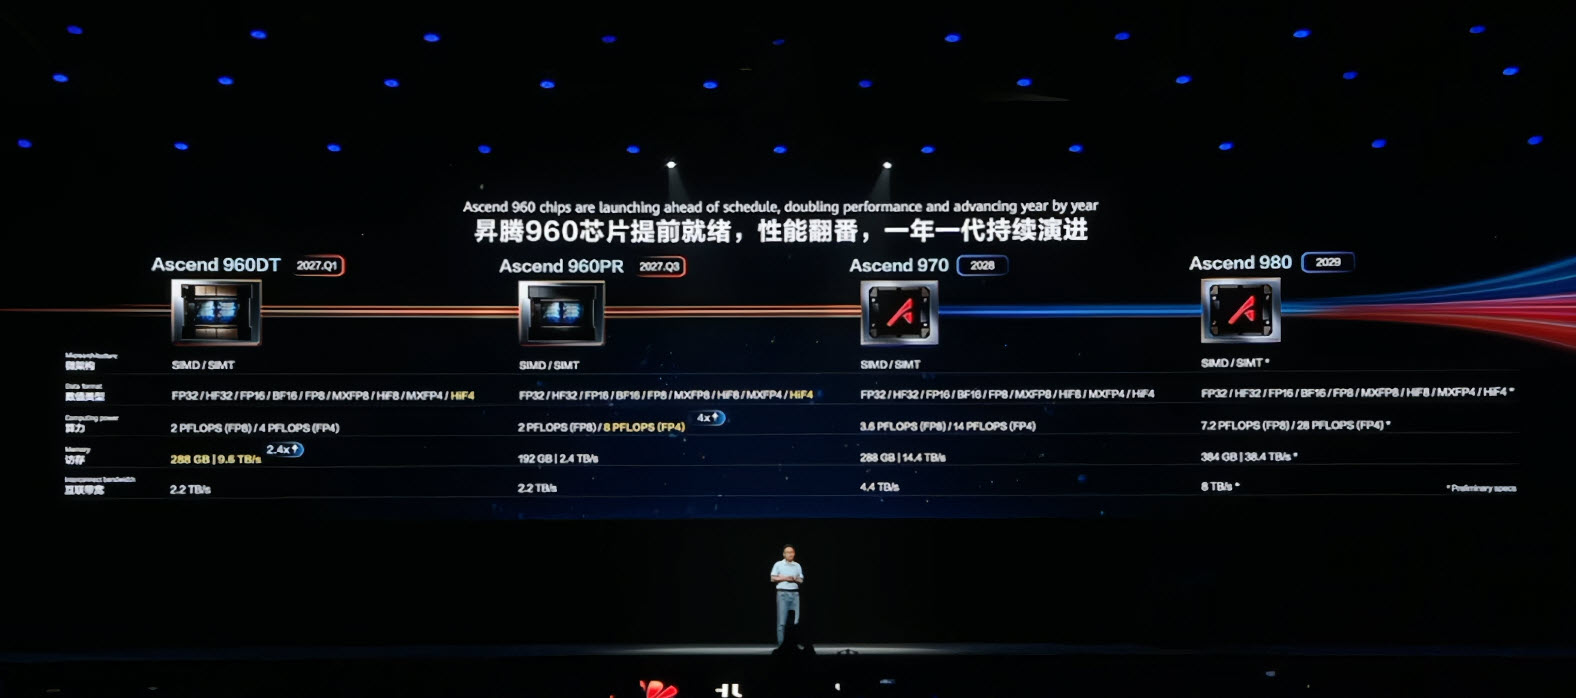
Le composant offrira jusqu’à 2 PFLOPs en calcul FP8 et 4 PFLOPs en FP4. Côté mémoire, il embarque 288 Go de HBM avec une bande passante de 9,6 To/s, soit 2,4 fois plus que la série Ascend 950. La bande passante d’interconnexion atteindra 2,2 To/s.
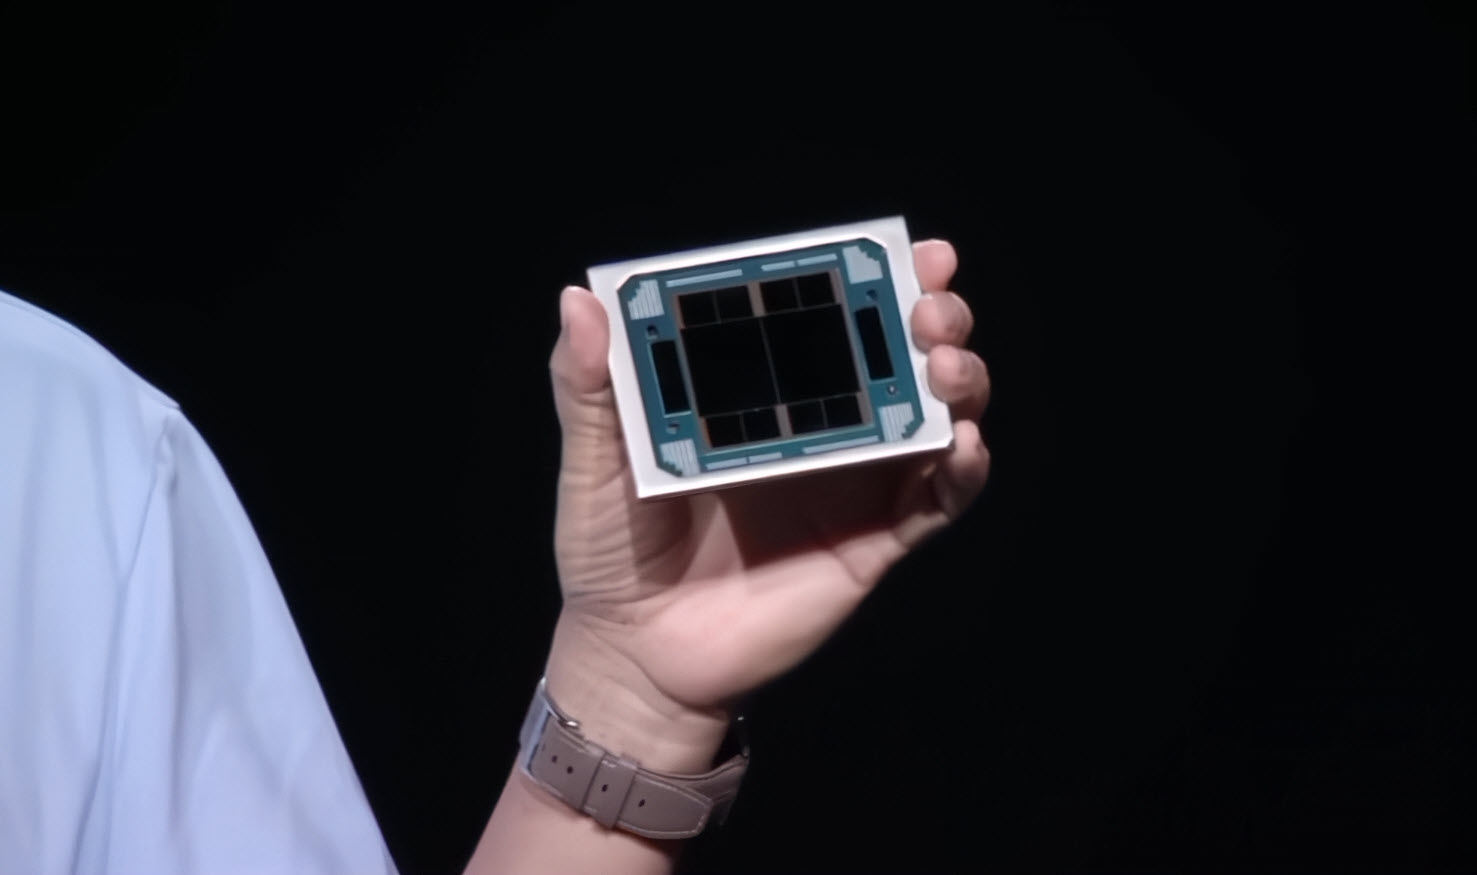
Après l’Ascend 960DT, Huawei lancera l’Ascend 960PR au troisième trimestre 2027. Cette version se concentre sur l’inférence, avec une puissance de calcul FP4 portée à 8 PFLOPs. Elle disposera de 192 Go de HBM à 2,4 To/s, tout en conservant une bande passante d’interconnexion de 2,2 To/s.
Ascend 970 pour 2028
Pour 2028, Huawei prévoit l’Ascend 970, une évolution architecturale majeure. Elle offrira 3,6 PFLOPs en FP8 et 14 PFLOPs en FP4. La mémoire HBM de 288 Go fonctionnera à 14,4 To/s, laissant supposer l’utilisation d’une nouvelle norme. La bande passante d’interconnexion doublera pour atteindre 4,4 To/s.
Ascend 980 pour 2029
L’Ascend 980, prévue pour 2029, poursuivra cette progression. Sa puissance sera de 7,2 PFLOPs en FP8 et 28 PFLOPs en FP4. Elle intégrera 384 Go de HBM avec un débit impressionnant de 38,4 To/s et une interconnexion à 8 To/s. Huawei précise que ces spécifications sont préliminaires et pourront évoluer.
| Puce | Sortie | Puissance de calcul | Mémoire | Interconnexion |
|---|---|---|---|---|
| Ascend 960DT | T1 2027 (3 trim. en avance) | 2 PFLOPs FP8 / 4 PFLOPs FP4 | 288 Go HBM @ 9,6 To/s | 2,2 To/s |
| Ascend 960PR | T3 2027 (1 trim. en avance) | 2 PFLOPs FP8 / 8 PFLOPs FP4 | 192 Go HBM @ 2,4 To/s | 2,2 To/s |
| Ascend 970 | 2028 | 3,6 PFLOPs FP8 / 14 PFLOPs FP4 | 288 Go @ 14,4 To/s | 4,4 To/s |
| Ascend 980 | 2029, préliminaire | 7,2 PFLOPs FP8 / 28 PFLOPs FP4 | 384 Go @ 38,4 To/s | 8 To/s |
Le SuperPod Ascend 960 double les performances avec l’optique NPO
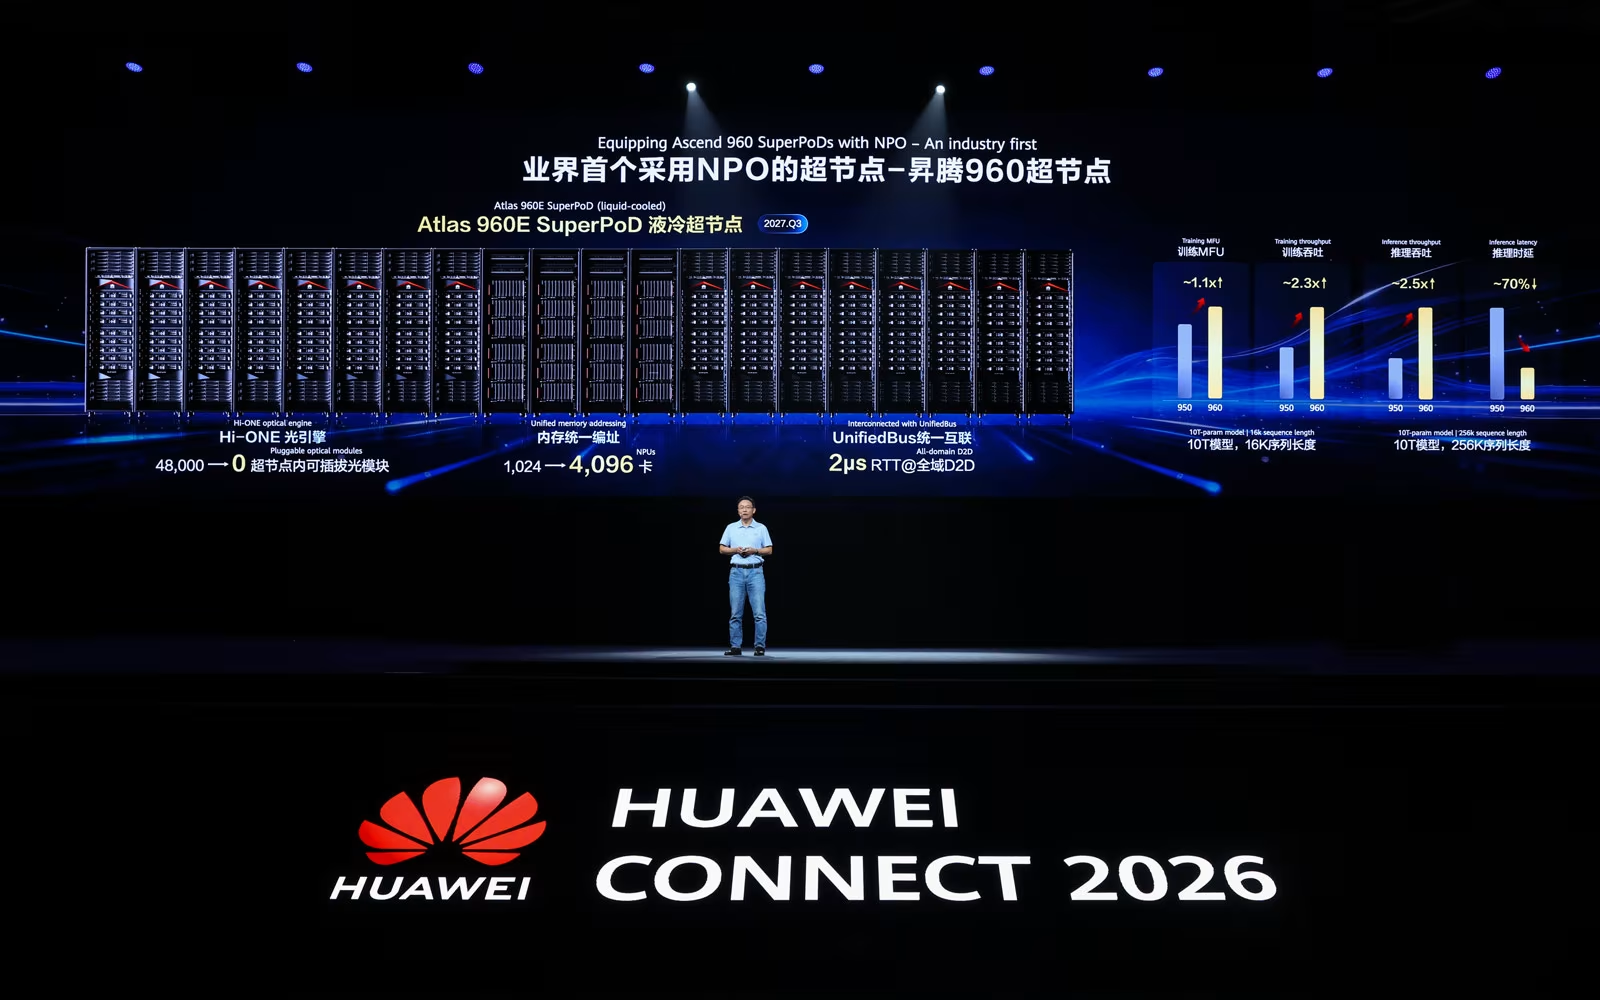
Le Huawei Atlas 960E SuperPod a été annoncé comme la première solution au monde à utiliser l’optique NPO (Near-Package Optics), avec une vitesse de transmission de 7,2 Tbps. Prévu pour le troisième trimestre 2027 et refroidi par liquide, ce système fournira 8 Exaflops en FP8 et 16 Exaflops en FP4.
- Premier SuperPod utilisant l’optique NPO via le moteur optique Hi-ONE de Huawei (7,2 Tbps par moteur)
- 4 096 NPU avec adressage mémoire unifié
- 8 EFLOPS FP8 / 16 EFLOPS FP4
- Environ 1 Po de HBM selon certains briefings ; un pool mémoire unifié de 256 To est aussi cité
- ~5 500 modules Hi-ONE remplaçant des dizaines de milliers de modules 800G pluggables, économie >550 kW, disponibilité revendiquée à 99,8 %
- Comparé à l’Atlas 950 : environ 2,3× le débit en entraînement et 2,5× en inférence sur des modèles de 10T paramètres, plus ~70 % de latence en inférence en moins
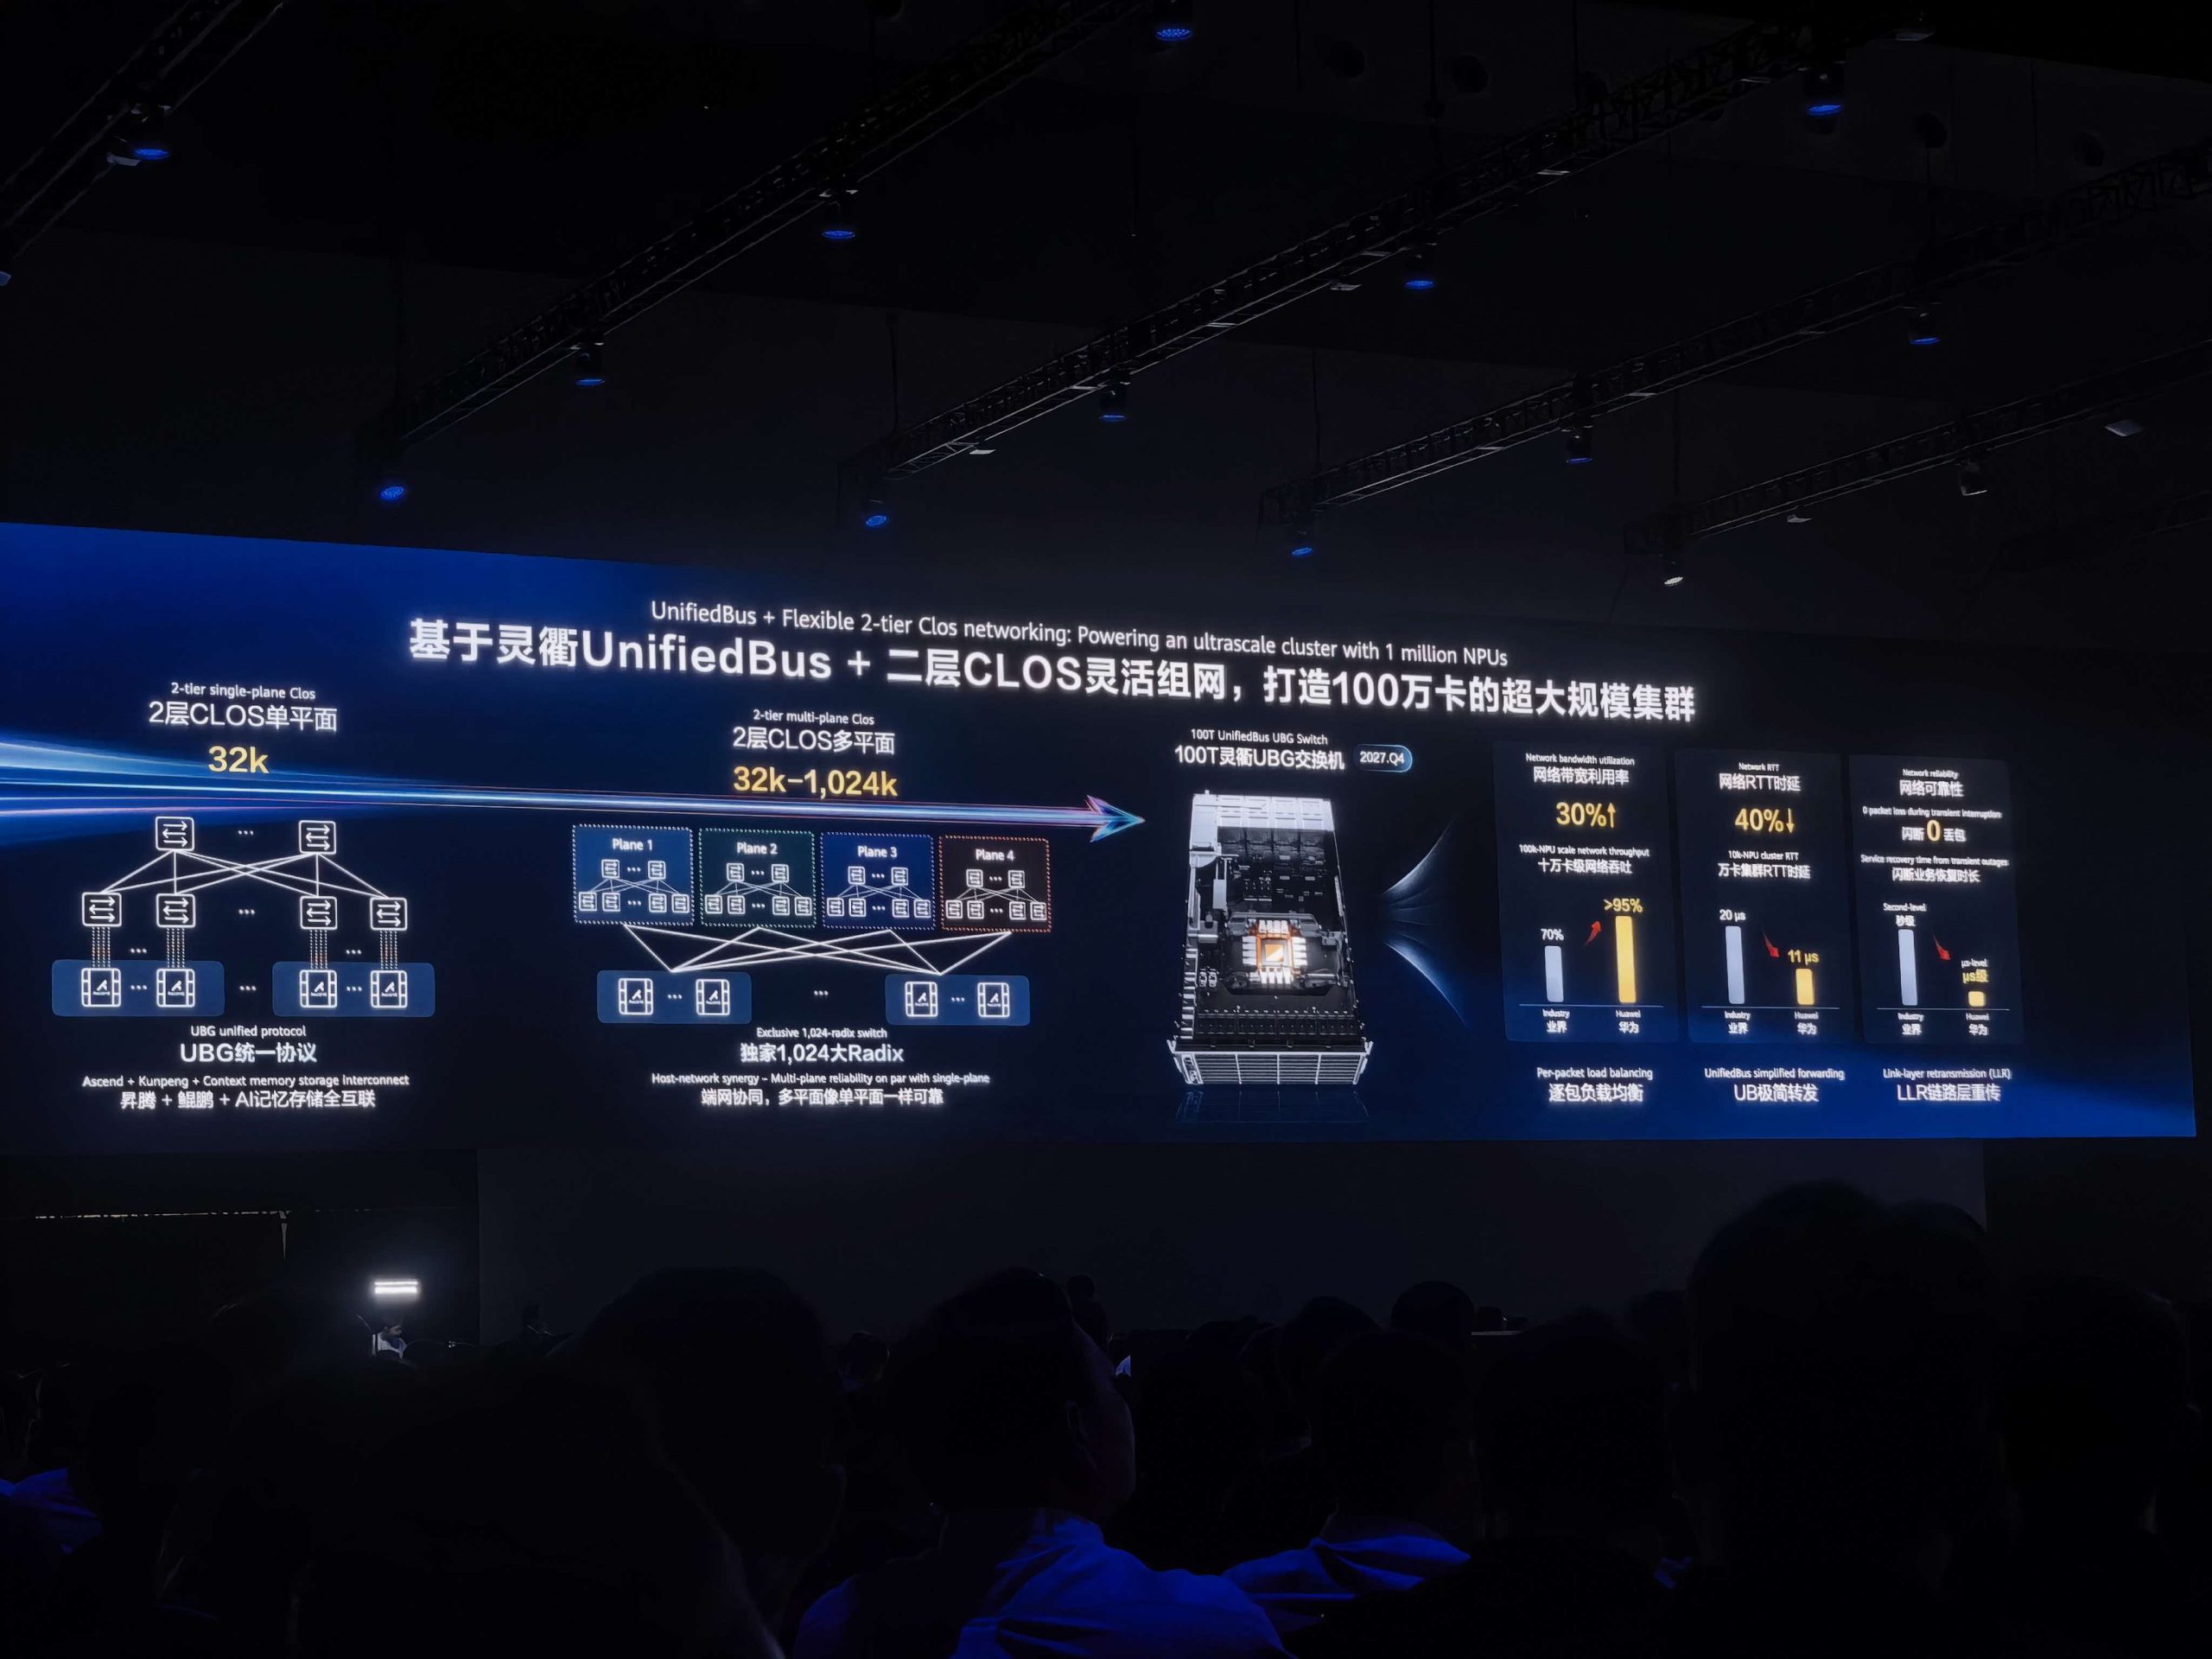
- Clusters multi-SuperPod via RoCE ou Lingqu : jusqu’à 512 000 accélérateurs, ou 1 million en topologie multi-tracks
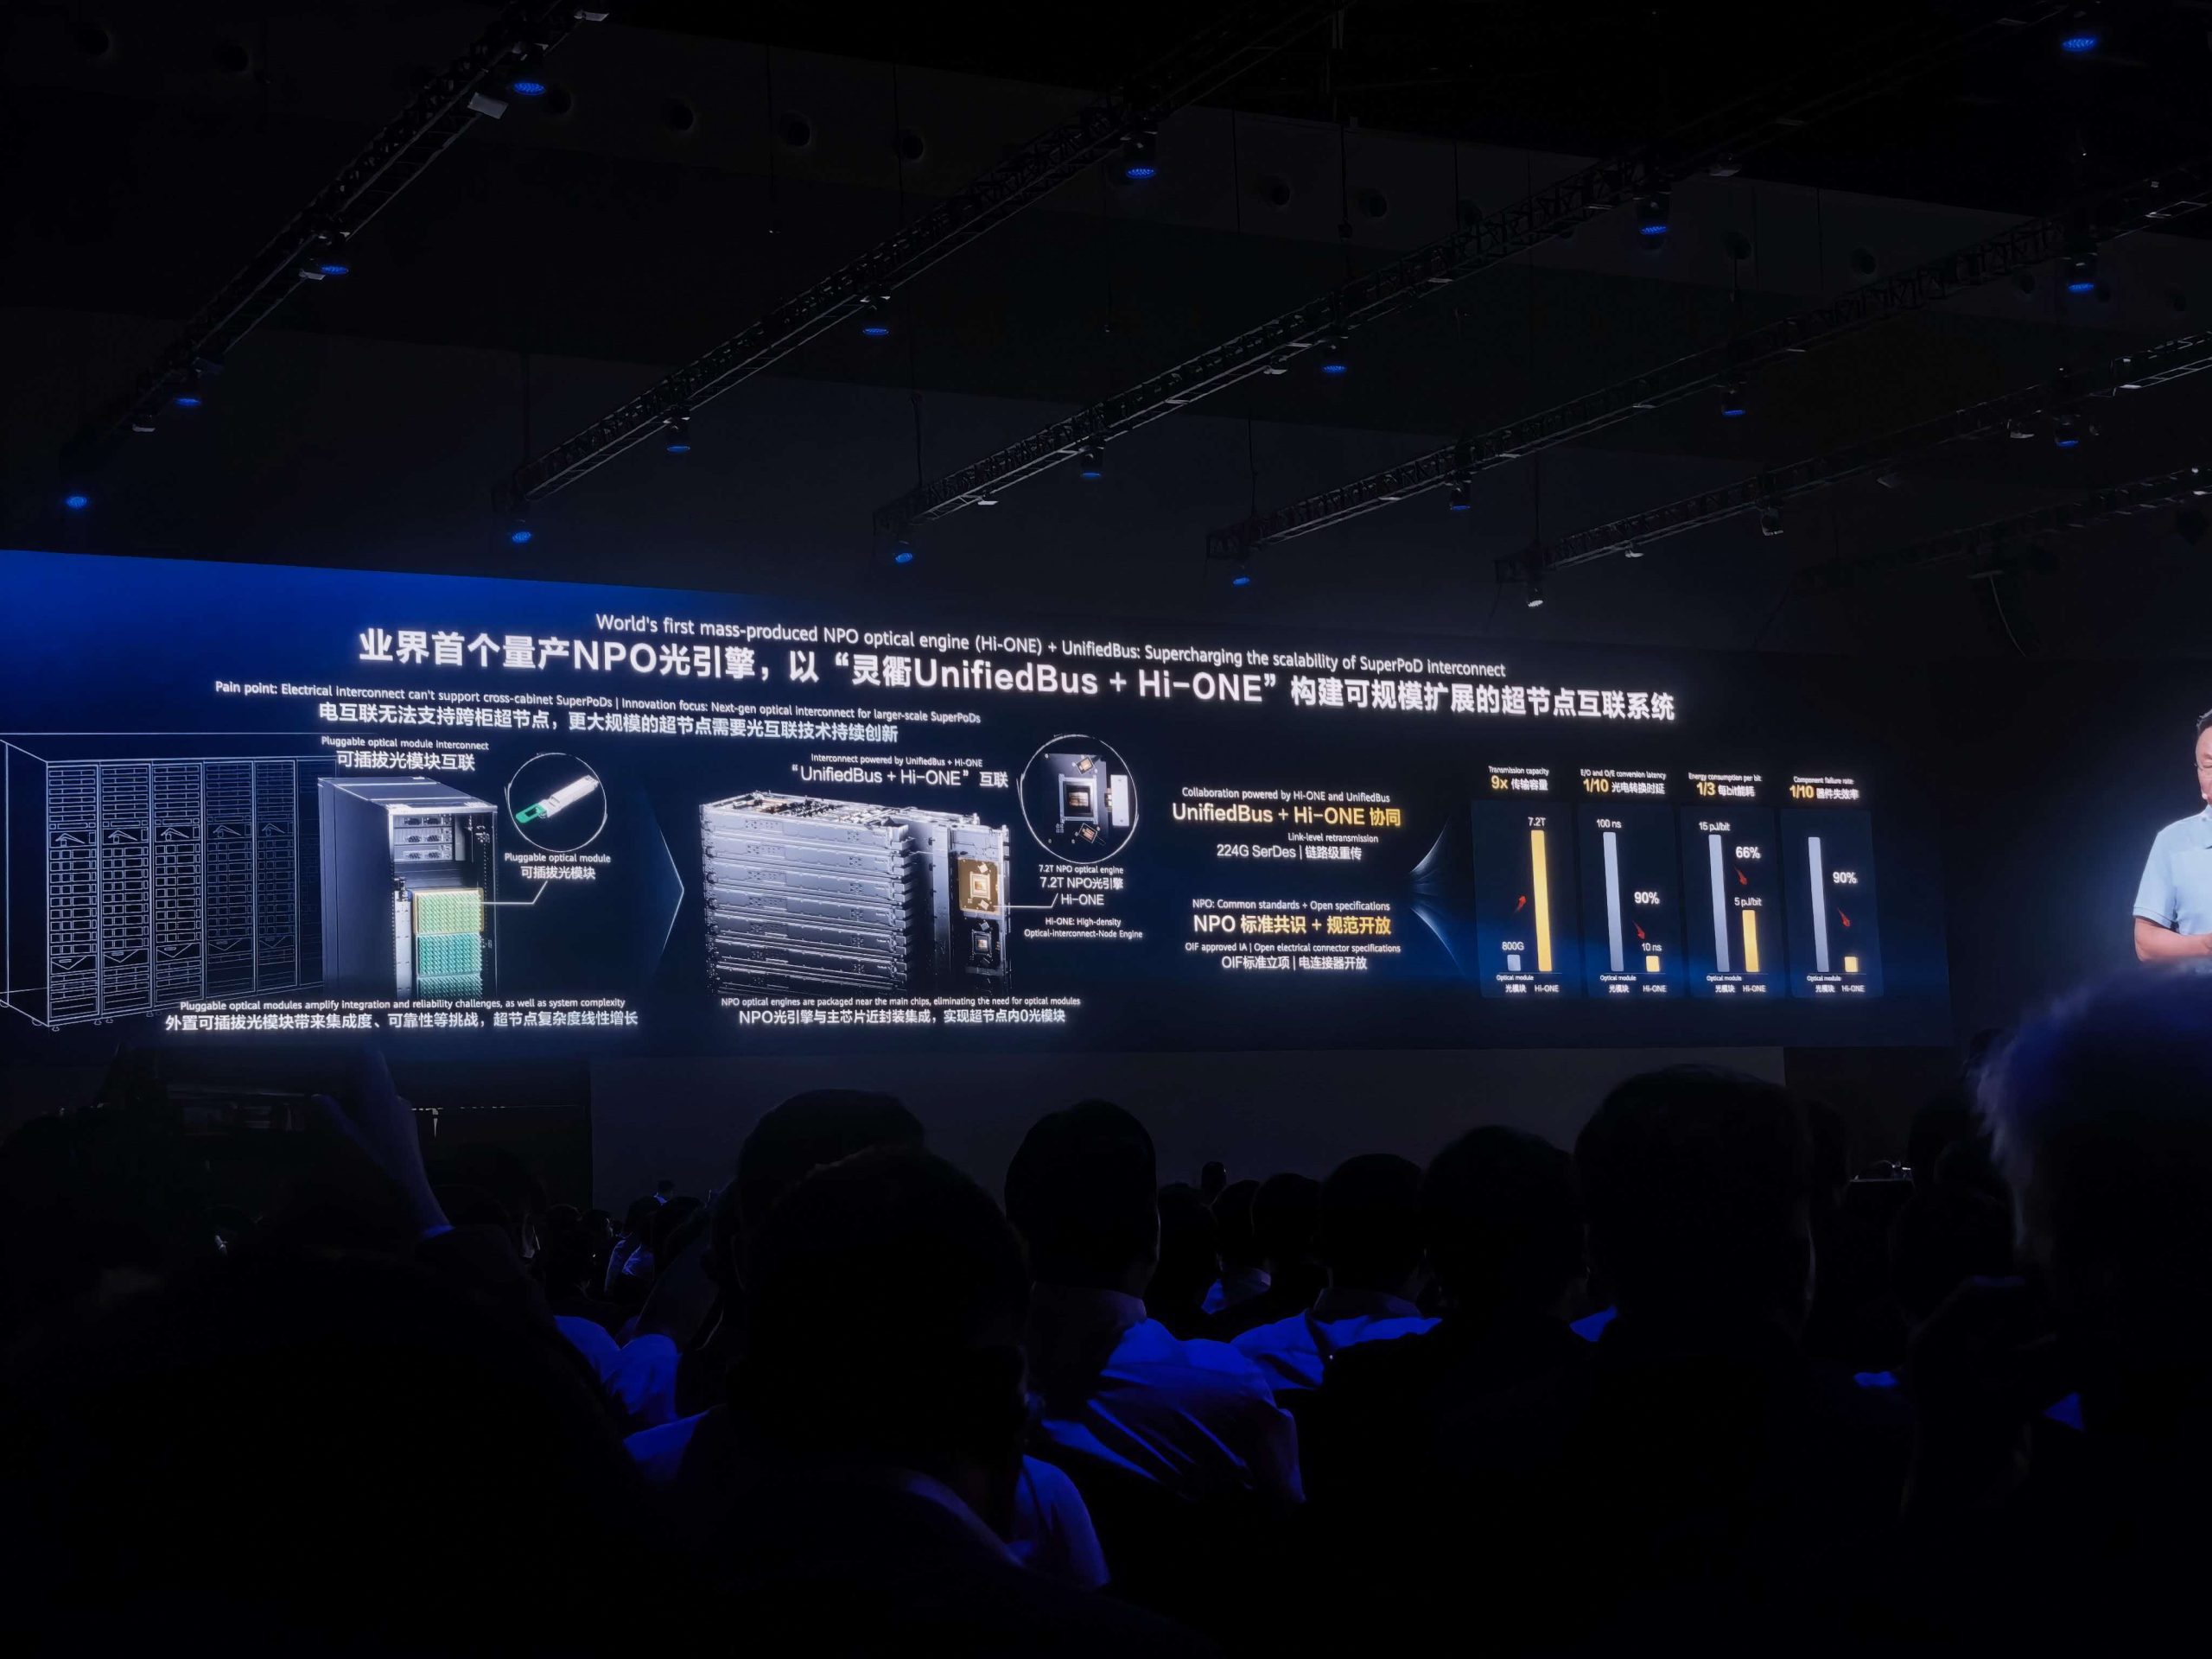
Ce système exploite le moteur optique Hi-ONE et le dernier UnifiedBus, offrant un temps aller-retour de 2 µs dans un environnement D2D. L’utilisation de 5 500 modules Hi-ONE réduit la consommation de plus de 550 kW. L’ensemble dispose d’un énorme pool mémoire unifié de 256 To.
Face aux SuperPods Atlas 950 existants, le 960E offre jusqu’à 2,3 fois le débit pour l’entraînement de modèles de 10T paramètres et 2,5 fois pour l’inférence. La latence en inférence est réduite de 70 %.
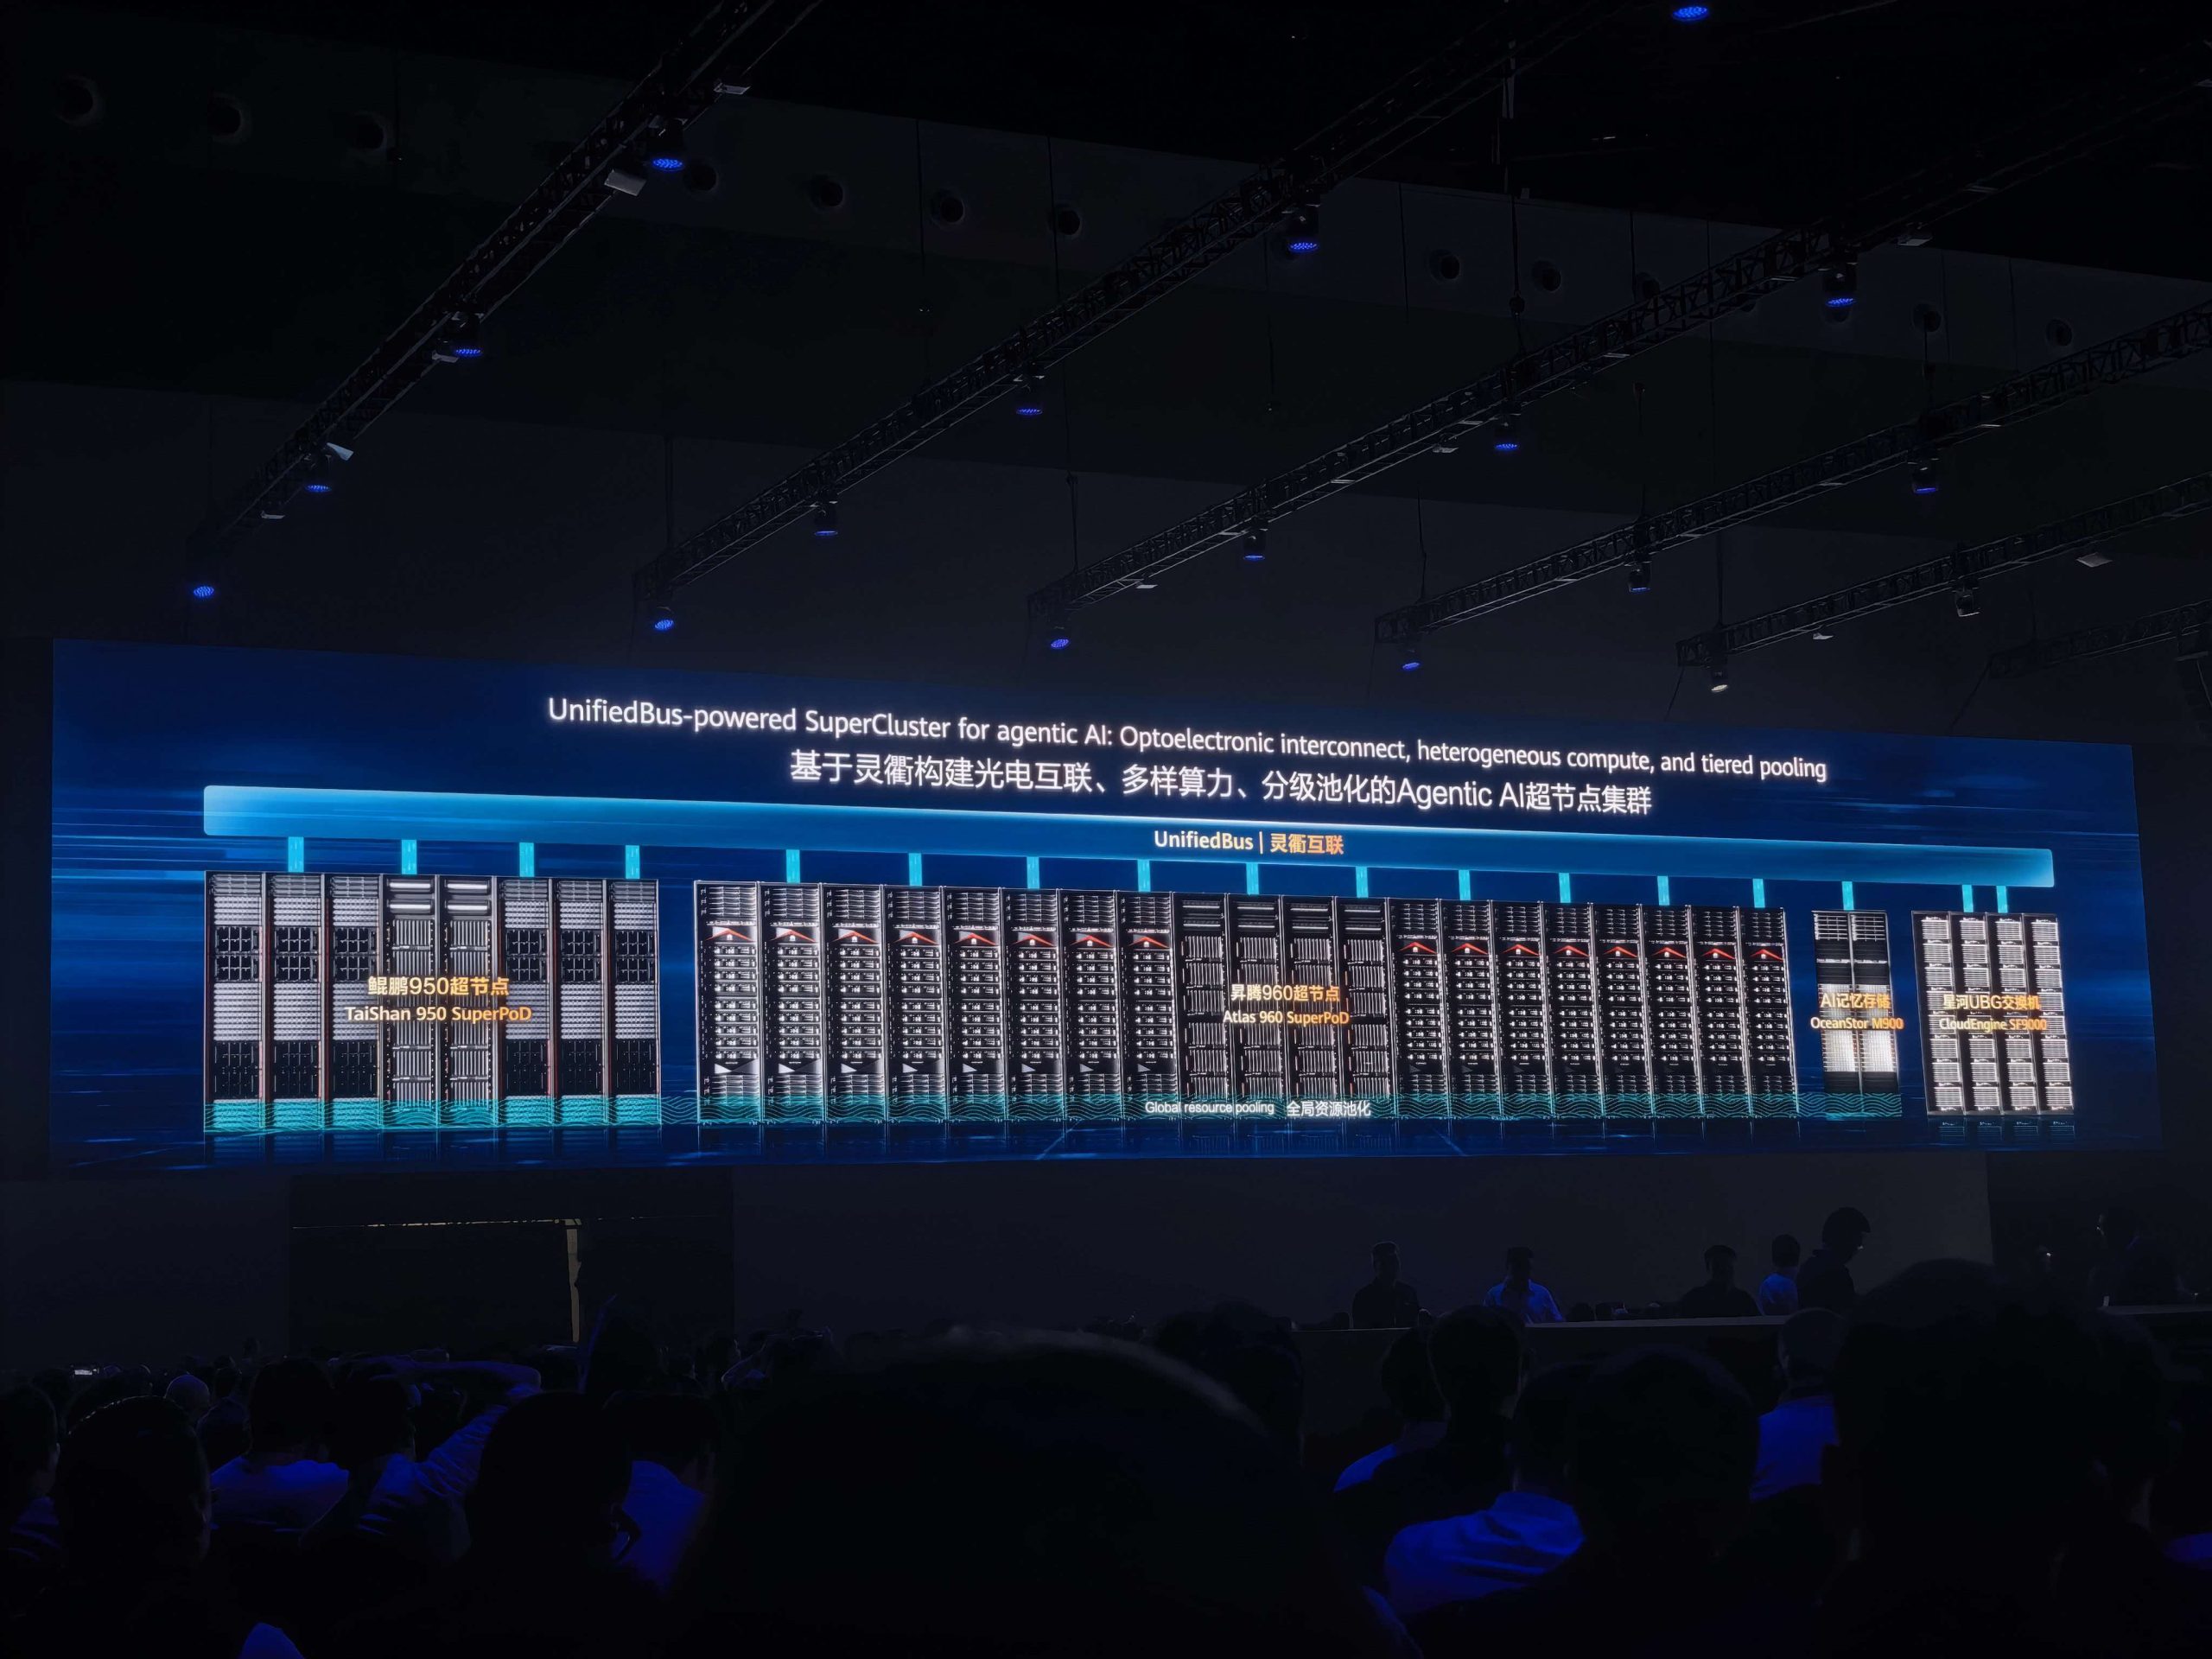
De plus, plusieurs SuperPods Atlas 960E pourront être interconnectés via RoCE ou Lingqu, formant des super clusters comptant jusqu’à 512 000 accélérateurs, voire un million avec une topologie multi-tracks.
Huawei s’attaque aussi aux besoins croissants en cache KV avec sa solution de mémoire et de stockage OceanStor M900 AI. Utilisant le réseau Lingqu, elle crée une solution de cache multi-niveaux global de niveau pétaoctet avec accès direct en un saut. OceanStor M900 étend le cache KV du SuperPod de la VRAM et de la mémoire vers le SSD. Un seul cluster peut offrir 64 Po de capacité, et le cache KV disponible par NPU passe des gigaoctets aux téraoctets, permettant de sauvegarder, partager et réutiliser plus de contexte pour améliorer le taux de succès du cache.
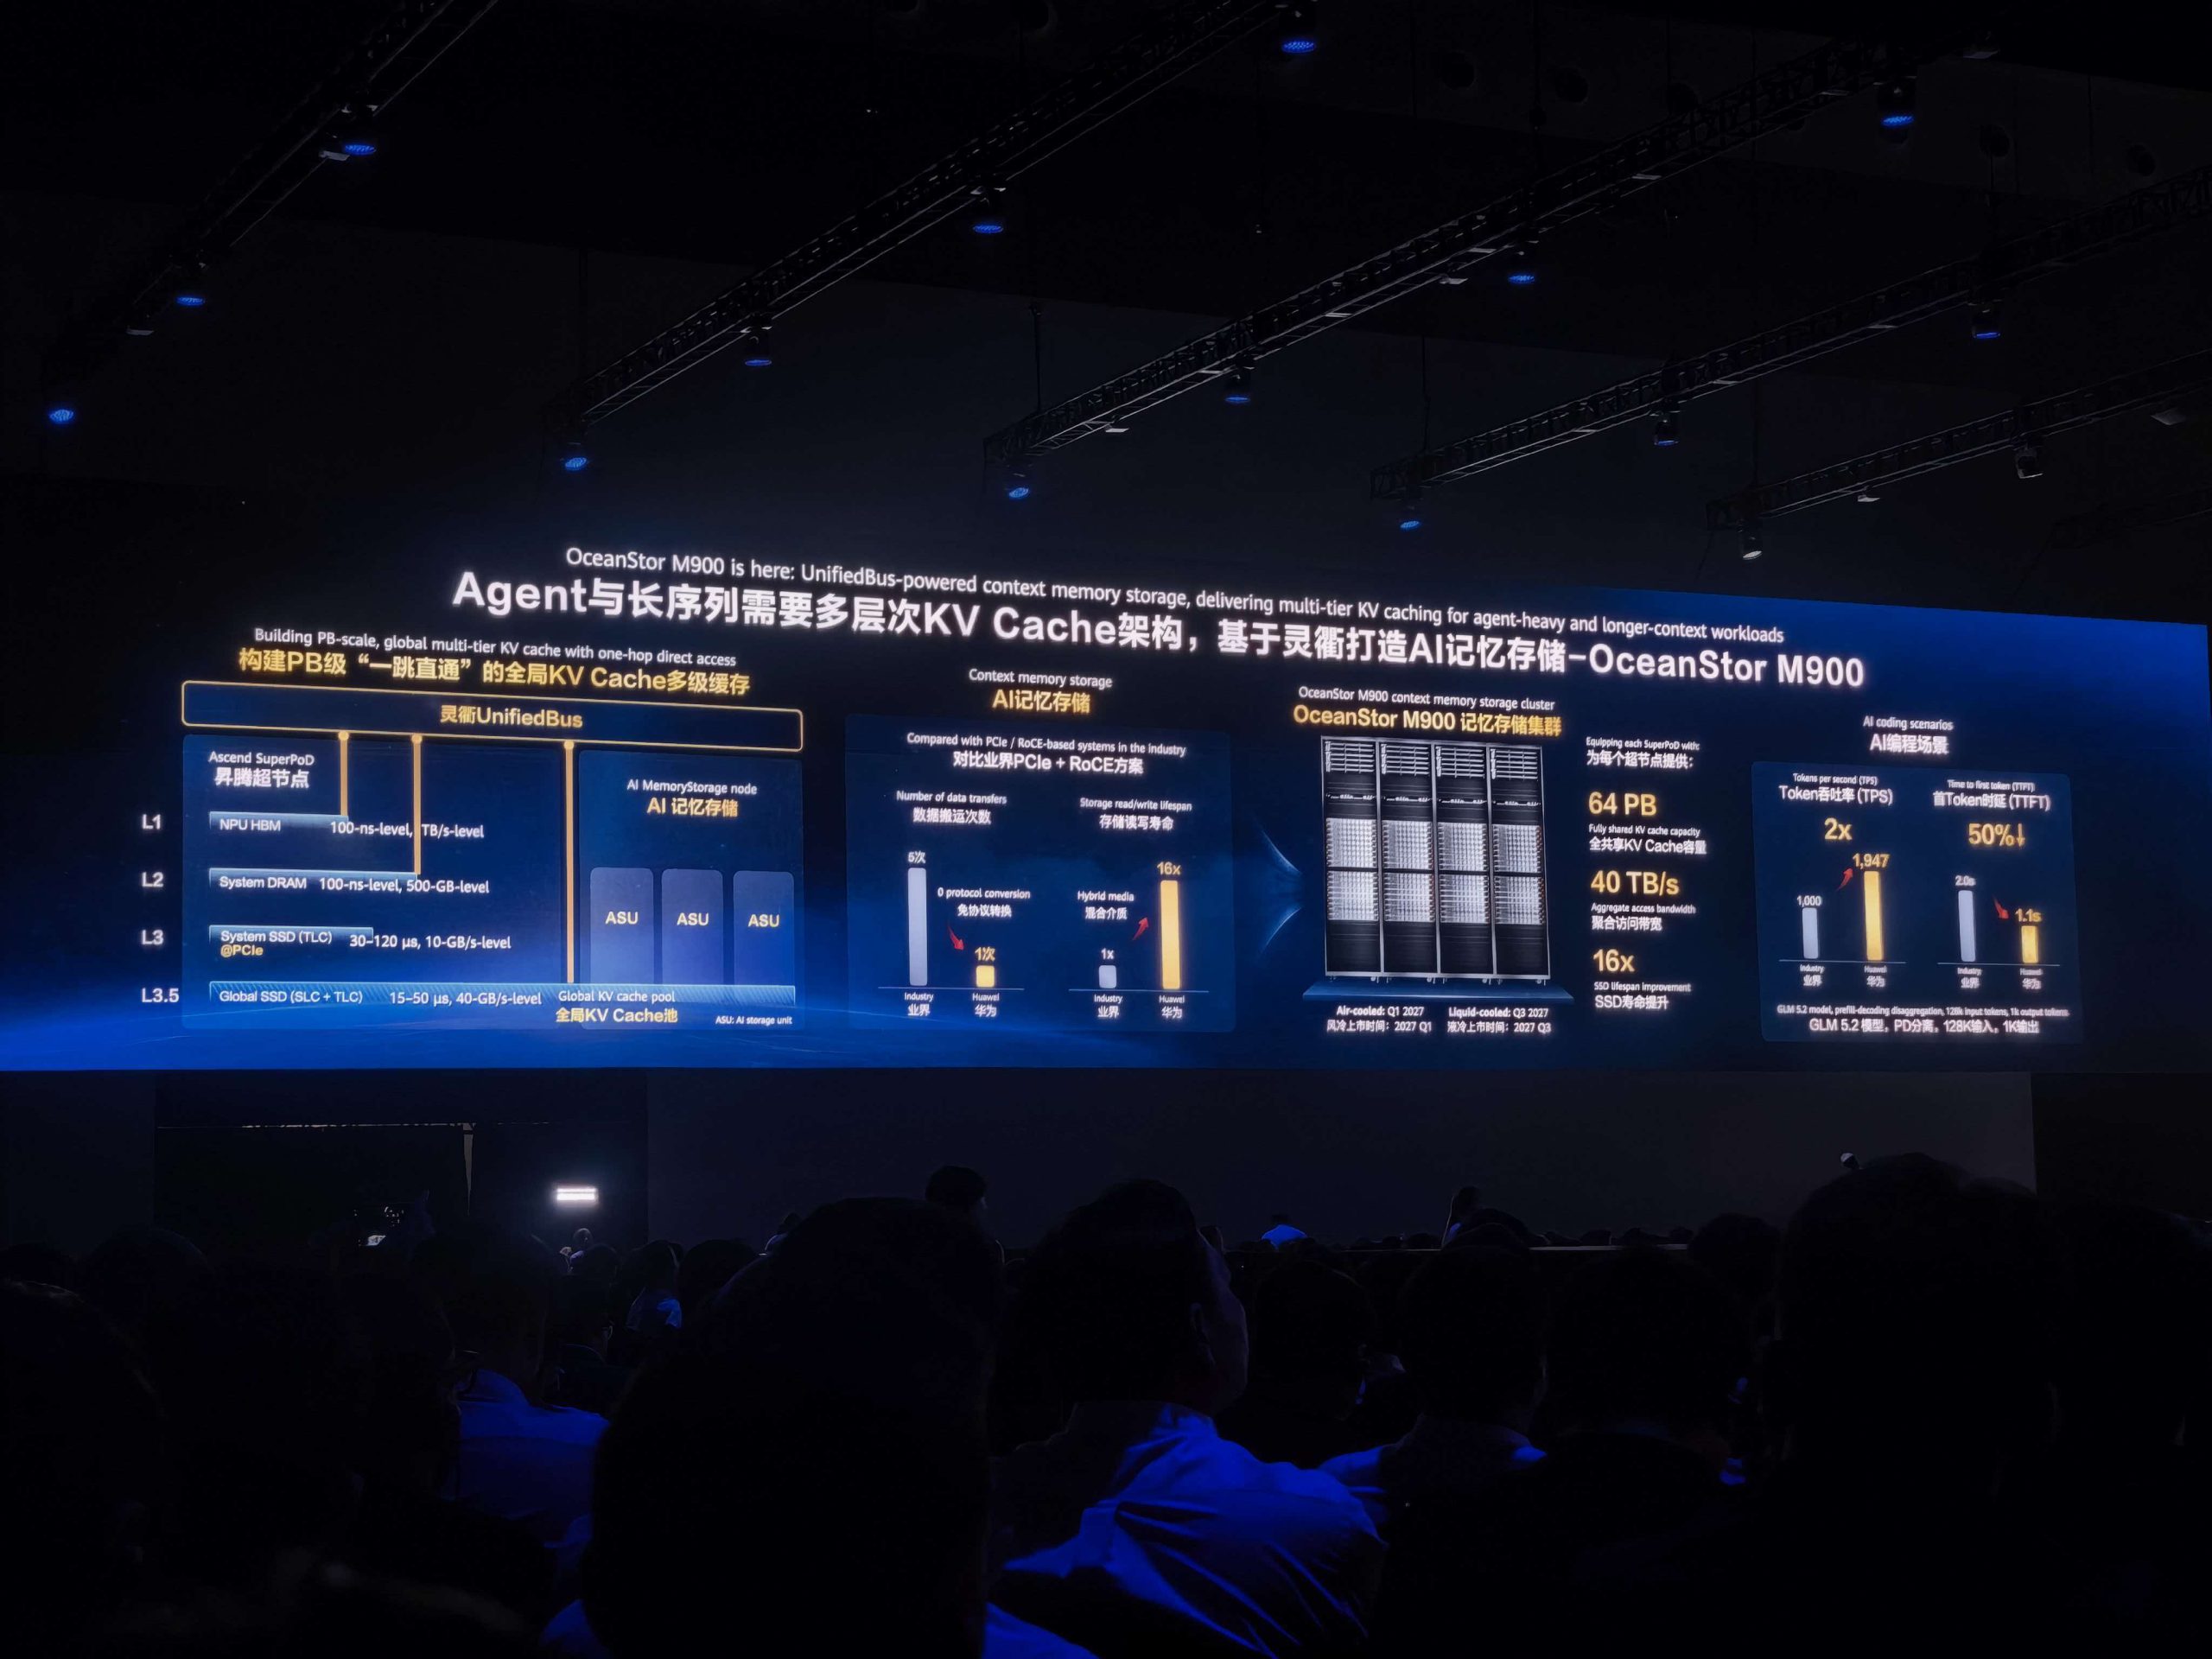
OceanStor M900 combine le CPU, le réseau et le contrôleur de disque, permettant aux SuperPods d’accéder directement du NPU au SSD en un saut, sans conversion de protocole ni transfert par le CPU. La latence d’accès chute de quelques millisecondes à 60 µs, une réduction de 90 %. Un seul cluster peut fournir une bande passante agrégée de 40 To/s, soit 1,5 fois plus que les standards du secteur selon Huawei.
Toutes ces annonces montrent que Huawei ne mise plus uniquement sur une puce phare. La société a avancé la famille Ascend 960 et a établi un rythme annuel avec les 970 et 980. L’élément central reste l’Atlas 960 SuperPod, qui utilise l’optique NPO et des milliers de NPU pour transformer l’échelle, la mémoire et l’interconnexion en gains de performance réels. Si la roadmap se concrétise, la stratégie de Huawei est claire : gagner la course à l’IA avec des systèmes plus rapides et des clusters plus profonds, et pas seulement avec une puce plus performante.