Étude : les modèles LLM de pointe rivalisent à peine avec des rédacteurs amateurs
L’intelligence artificielle progresse dans l’écriture créative, mais les humains gardent encore une longueur d’avance. Un nouveau benchmark révèle que seuls les modèles les plus avancés parviennent à égaler les écrivains amateurs, tandis que les professionnels restent hors de portée.
GPT 6 Astra en tête face aux amateurs
Le cabinet Vulsar AI a publié un benchmark évaluant la qualité de l’écriture créative longue de plusieurs grands modèles de langage, en les comparant à des rédacteurs humains. Basé sur 475 prompts, l’étude montre que seuls les modèles dits « frontière » parviennent à rivaliser avec les humains, et uniquement avec les écrivains amateurs, pas avec les professionnels.
Le classement général place GPT 6 Astra en première position avec un taux de victoire prédit de 87.8%, devançant de justesse le groupe des rédacteurs amateurs, qui atteint 86.6%. L’écart de compétence entre amateurs et professionnels reste toutefois très marqué. Le podium est complété par le GPT 5.6 Sol d’OpenAI (77.6%) et le Claude Fable 5.1 d’Anthropic (70.3%). Les scores chutent radicalement dès que l’on s’éloigne de ces modèles les plus complexes.
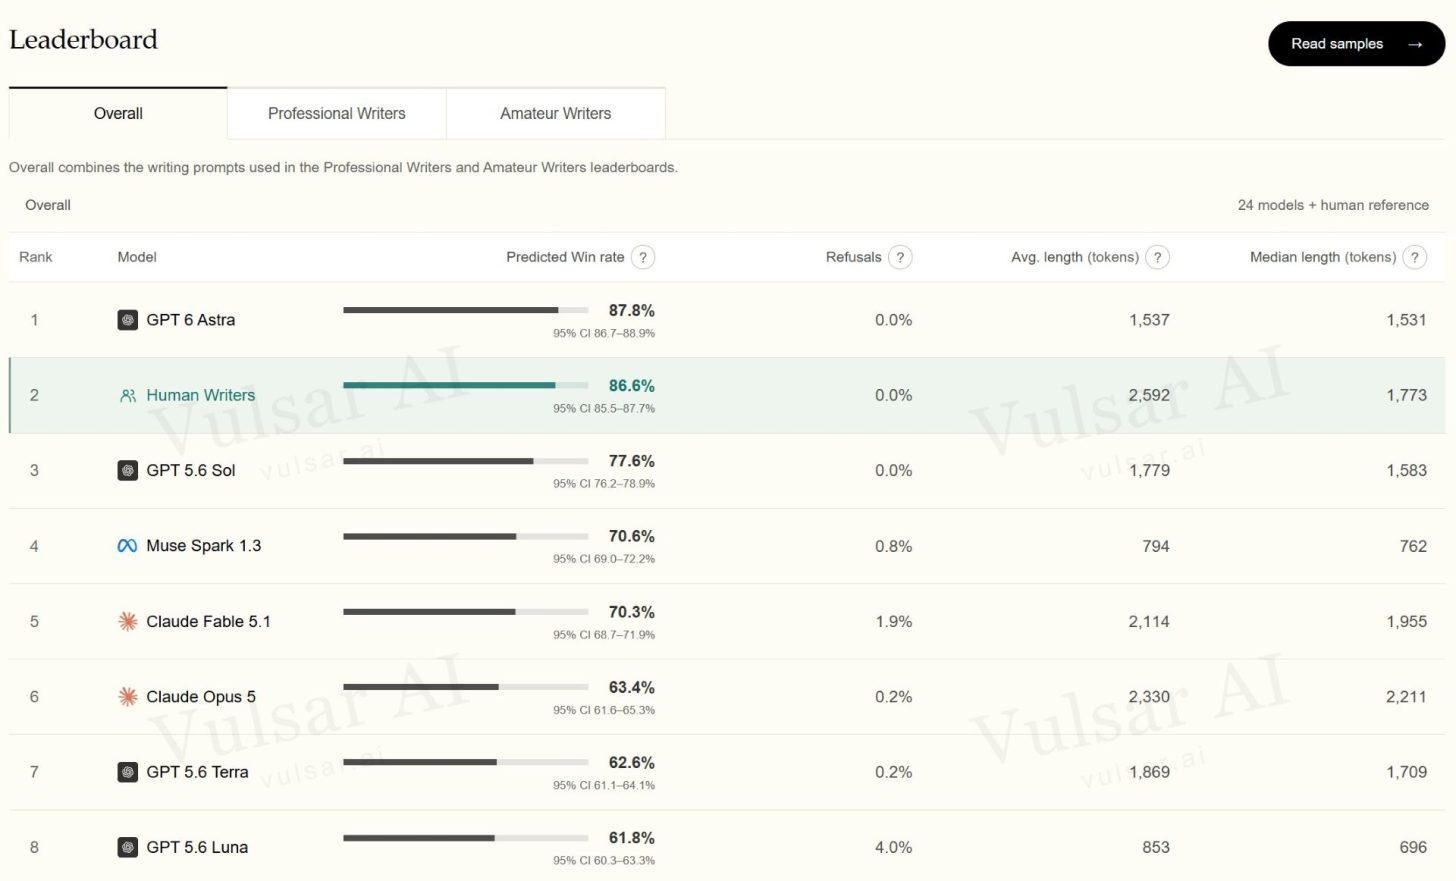
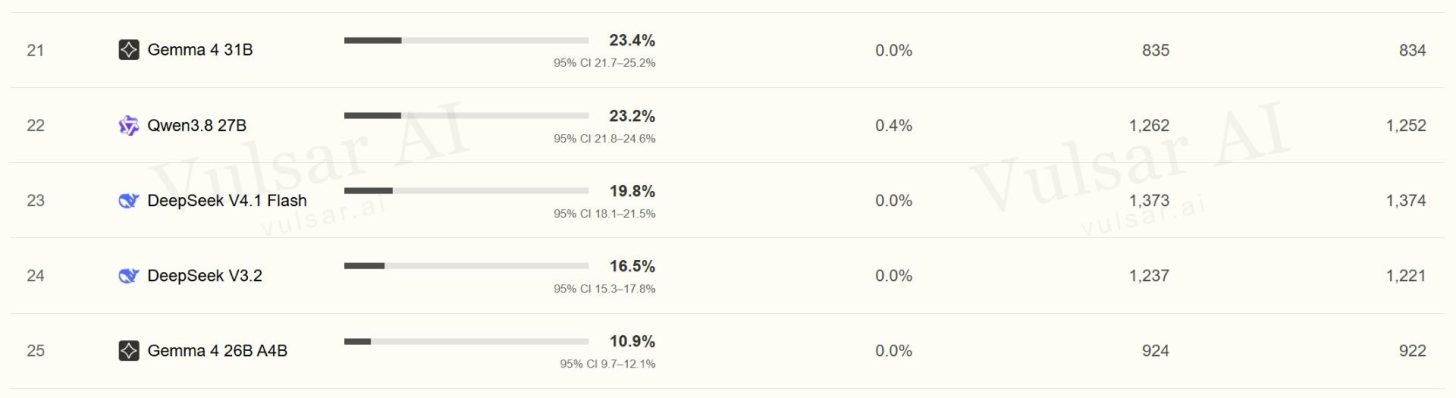
Des modèles pourtant renommés comme Claude Opus 5 ou Grok 4.6 se situent dans la fourchette 50-65%. Les performances des modèles plus légers sont encore moins convaincantes, avec par exemple Qwen3.8-27B à 23.2% et Gemma 4 26B qui ferme la marche avec seulement 10.9%.
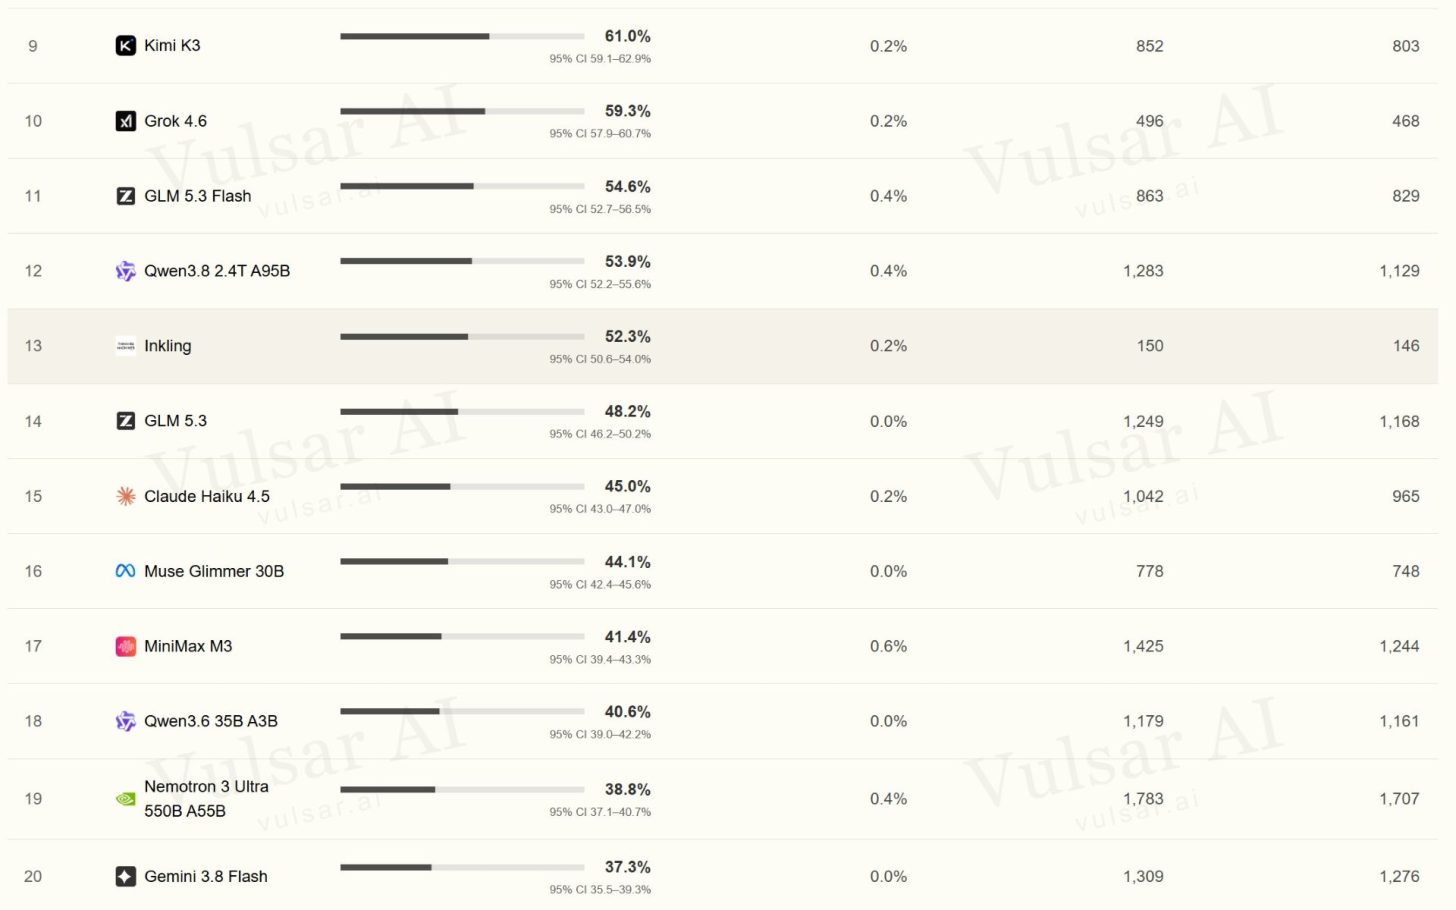
En volume de production, les humains génèrent le plus de tokens par prompt, avec 2 592 unités. GPT 6 Astra en produit 1 537 et Claude Fable 5.1, 2 114. Une limite des modèles plus petits, relevée dans des discussions en ligne, est leur tendance à perdre en cohérence sur des récits longs, devenant répétitifs, là où les écrivains conservent leur supériorité.
Les écrivains humains conservent leur capacité à maintenir une narration complexe et à adapter leur style de manière spontanée. La question de savoir quand les modèles de langage parviendront à reproduire le talent des professionnels reste ouverte.