Intel : l’accélérateur Crescent Island offre 1,3 PFLOPs FP8 pour 350W et vise la concurrence avec du LPDDR5X jusqu’à 480 Go
Intel officialise sa nouvelle famille de GPU D-Series, auparavant connue sous le nom de Crescent Island, destinée aux data centers IA. Basée sur l’architecture Xe3P, cette gamme cherche à se positionner face aux solutions de NVIDIA et AMD en privilégiant une approche axée sur l’efficacité et le coût.
Crescent Island : Une architecture pensée pour l’inférence IA
Le GPU Intel Crescent Island repose sur la toute nouvelle architecture Xe3P, la même qui a été présentée lors des plongées techniques sur Panther Lake et Xe3. La société dévoile aujourd’hui le nom de la famille et son premier produit, l’Intel GPU D270.
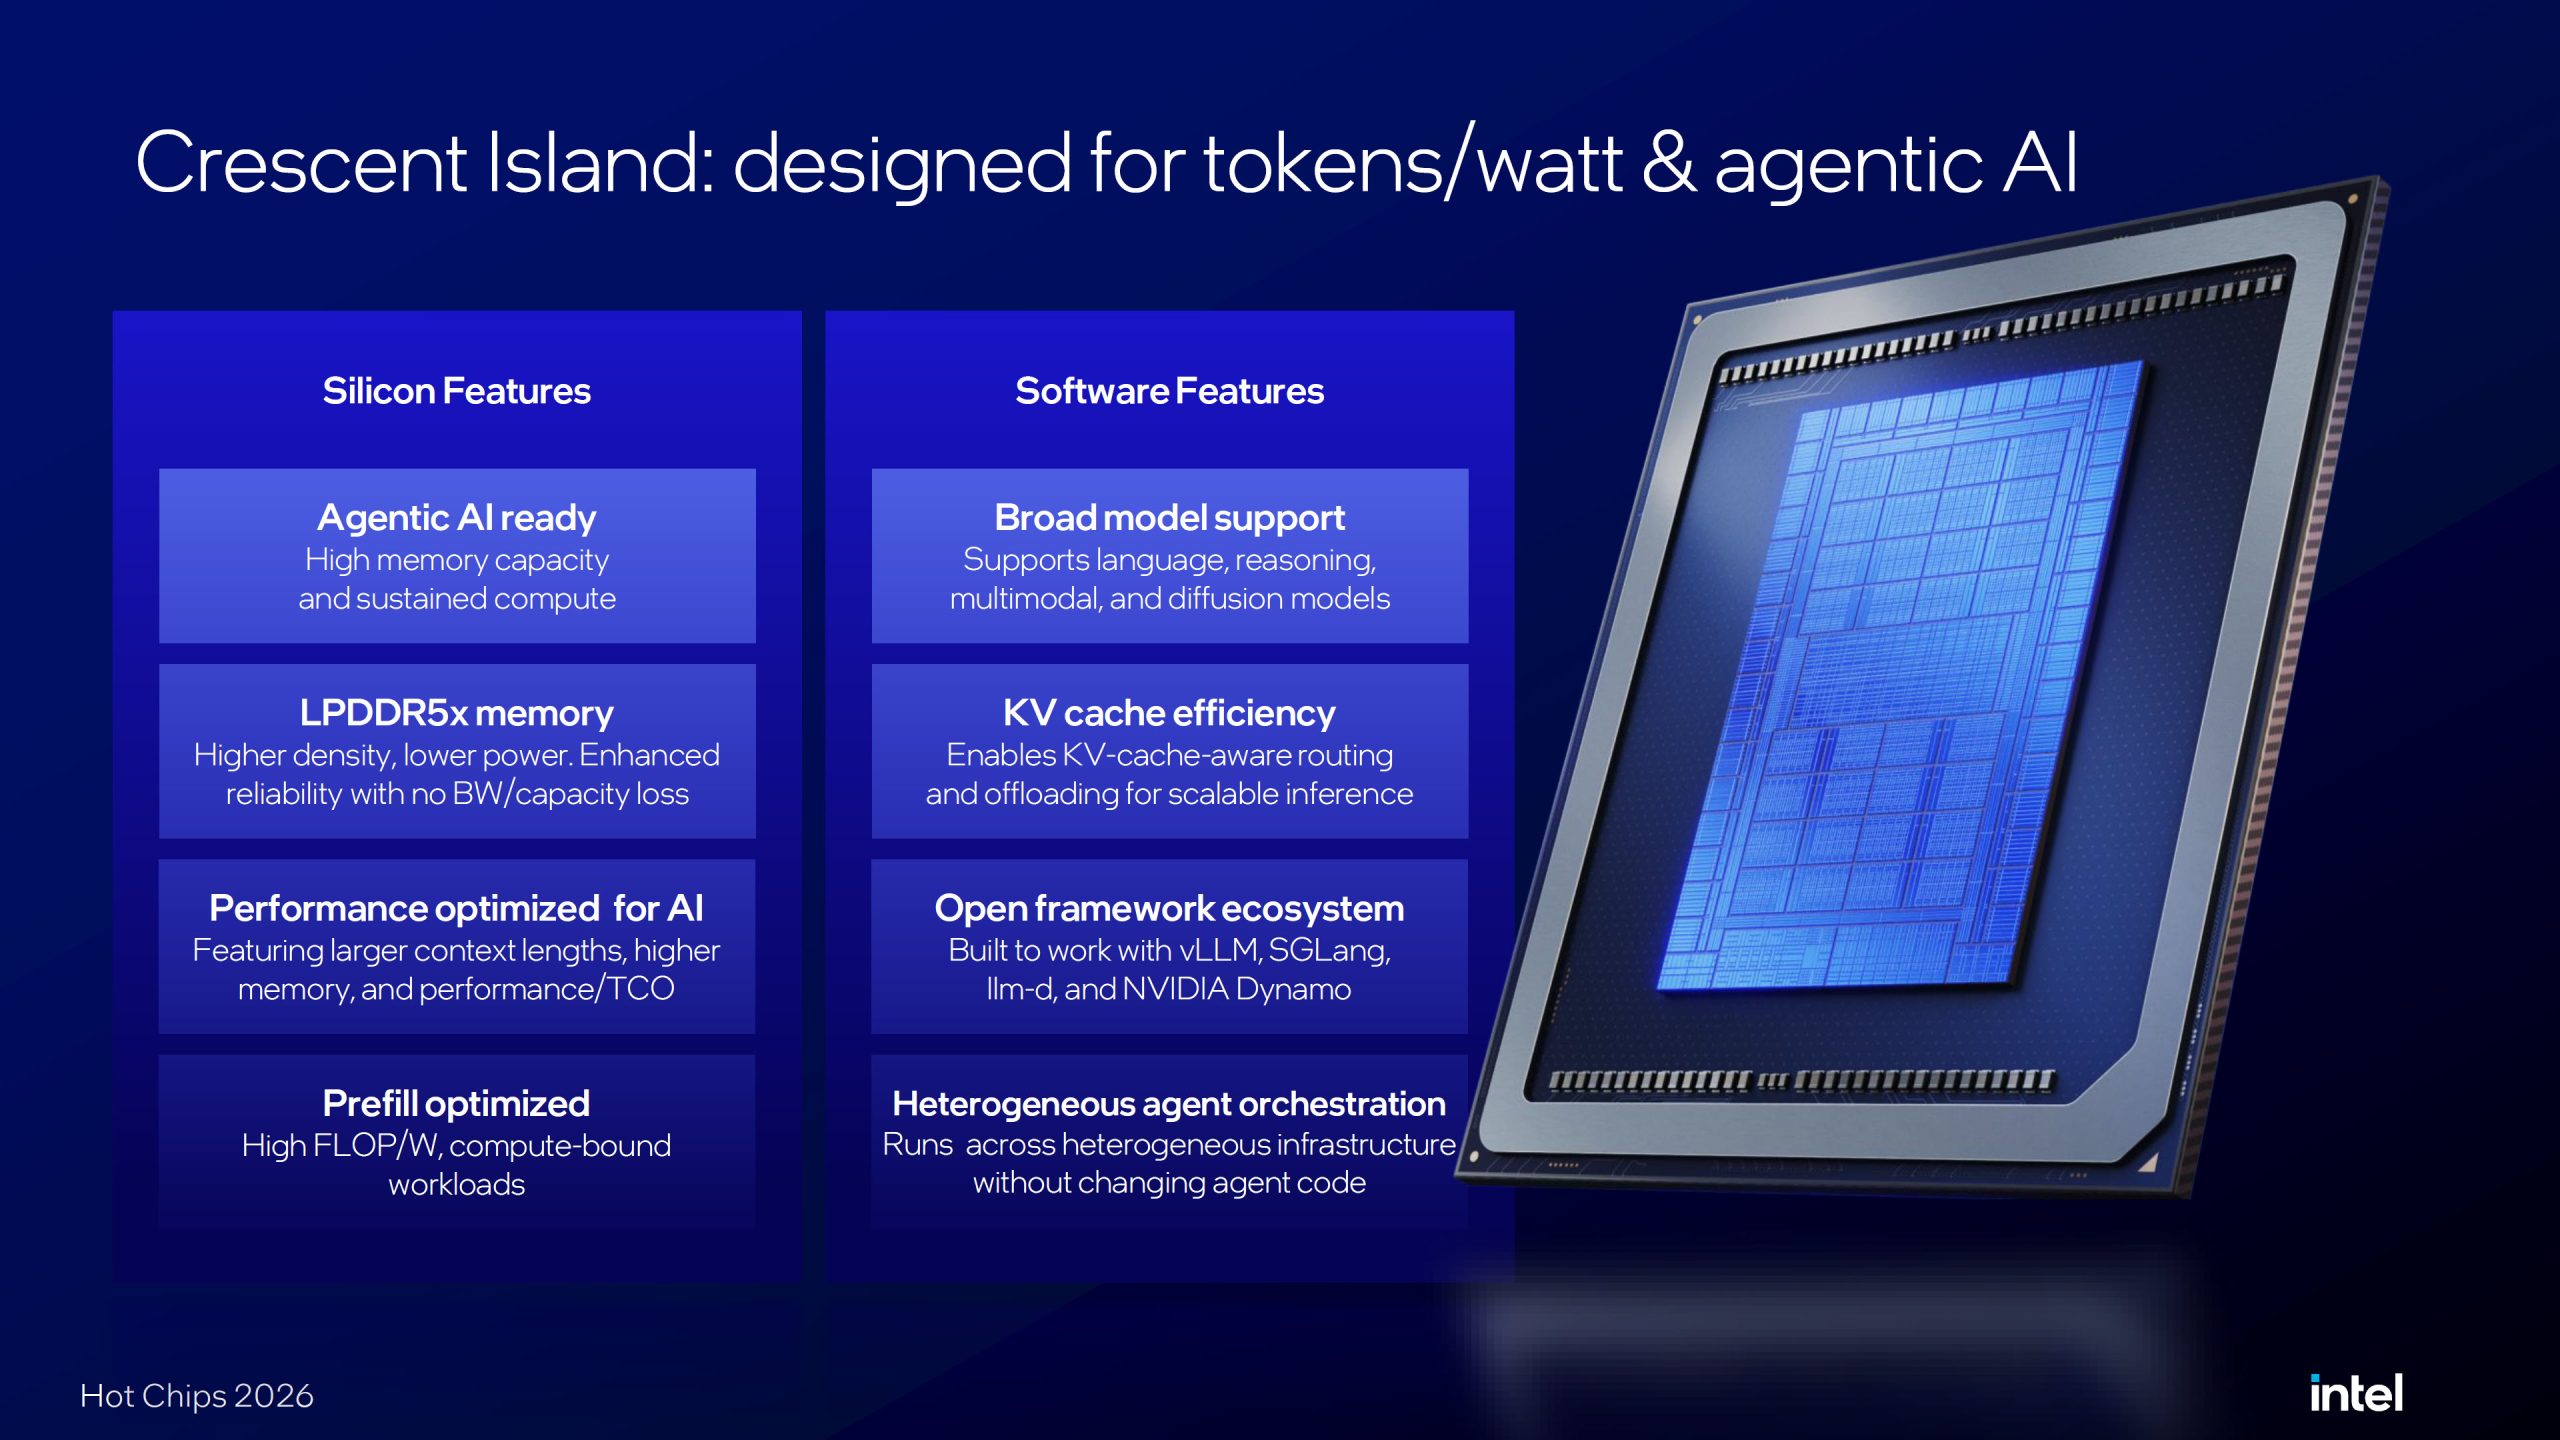
Les principales innovations matérielles de Crescent Island comprennent :
- Agentic AI Ready : Capacité mémoire élevée et puissance de calcul soutenue.
- LPDDR5x : Plus grande densité, consommation réduite. Fiabilité améliorée sans perte de bande passante ou de capacité.
- AI Optimized : Conçue pour les contextes longs, une mémoire importante et un bon rapport performance/coût total.
- Prefill Optimized : Haut rapport FLOPS par watt, pour les charges de travail liées au calcul.
Les avancées logicielles pour Crescent Island incluent :
- Large support de modèles : Prend en charge les modèles de langage, de raisonnement, multimodaux et de diffusion.
- Efficacité du cache KV : Permet un routage et un déchargement conscients du cache KV pour une inférence évolutive.
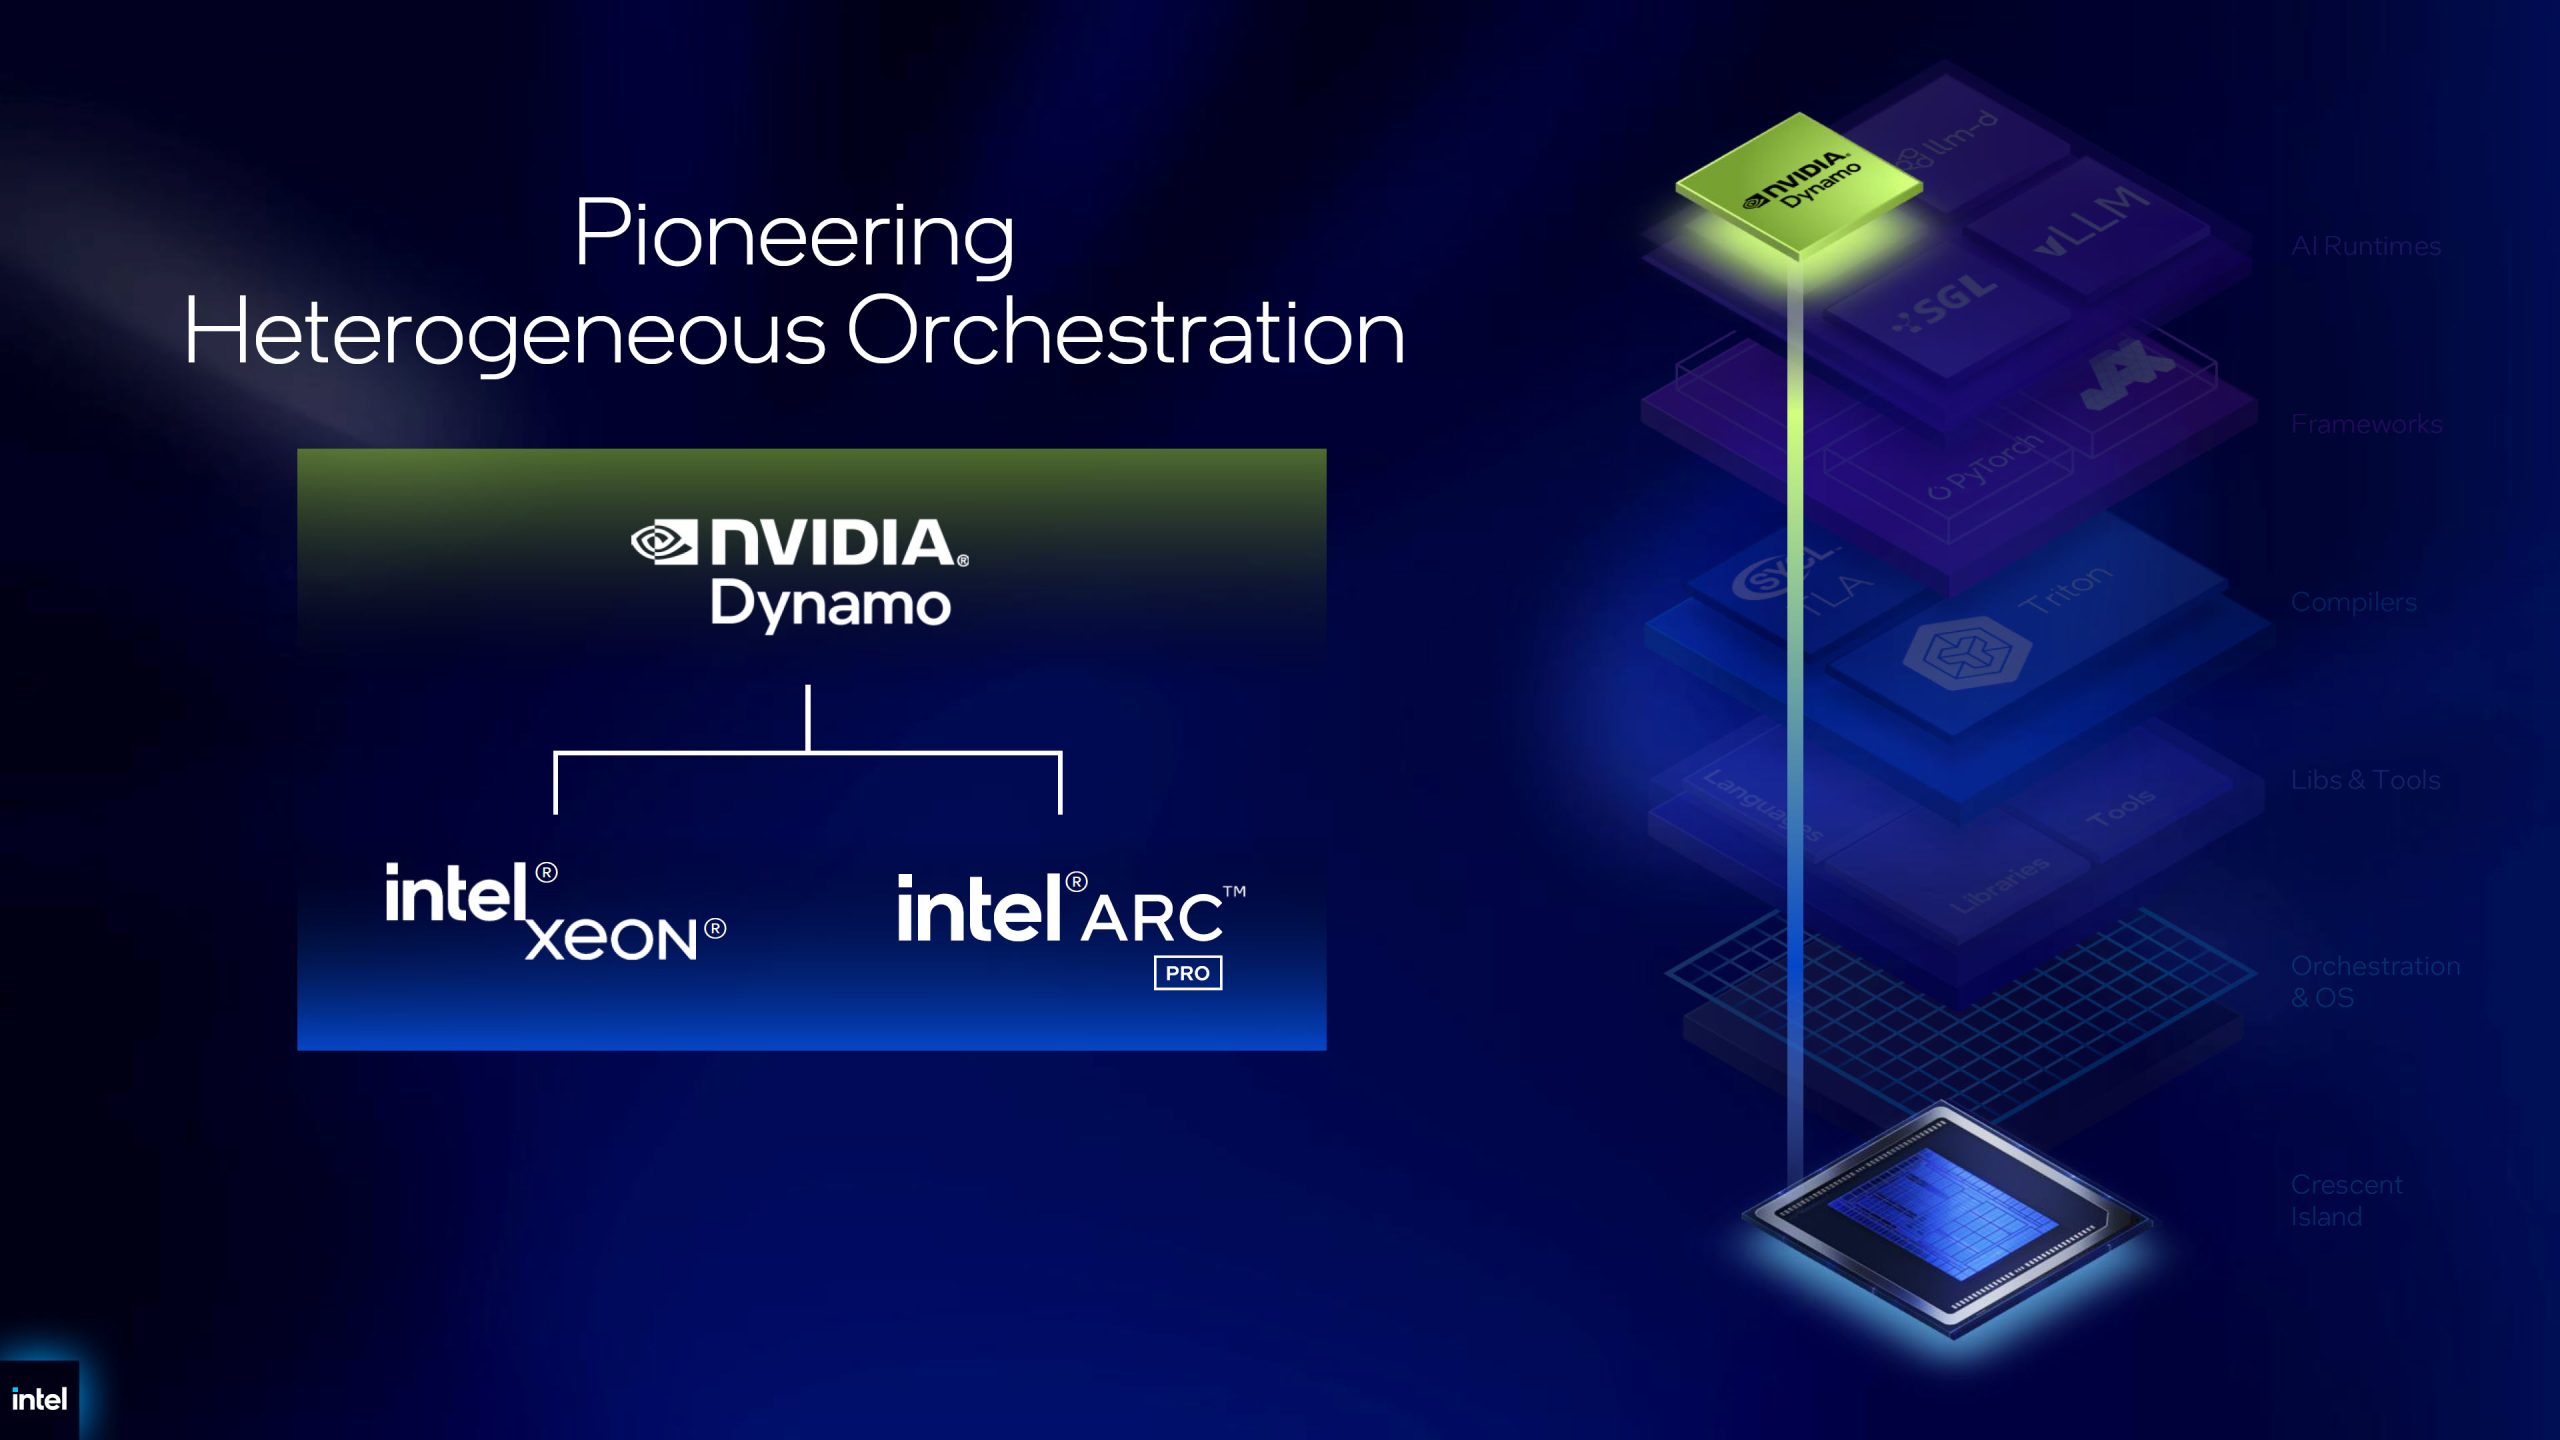
- Écosystème ouvert : Conçue pour fonctionner avec vLLM, SGLANg, llm-d et NVIDIA Dynamo.
- Orchestration hétérogène : Fonctionne sur une infrastructure hétérogène sans modification du code de l’agent.
L’architecture GPU Xe3P de la série D représente une évolution de l’architecture Xe3. Elle équipera la prochaine famille Arc pour clients, la série C, mais sa conception est encore plus évolutive, des iGPU clients aux GPU IA pour data centers.
- Microarchitecture Xe3P optimisée pour la performance par watt.
- 480 Go de mémoire LPDDR5X.
- Support d’un large éventail de types de données, idéal pour les fournisseurs de « tokens-as-a-service » et les cas d’usage d’inférence.
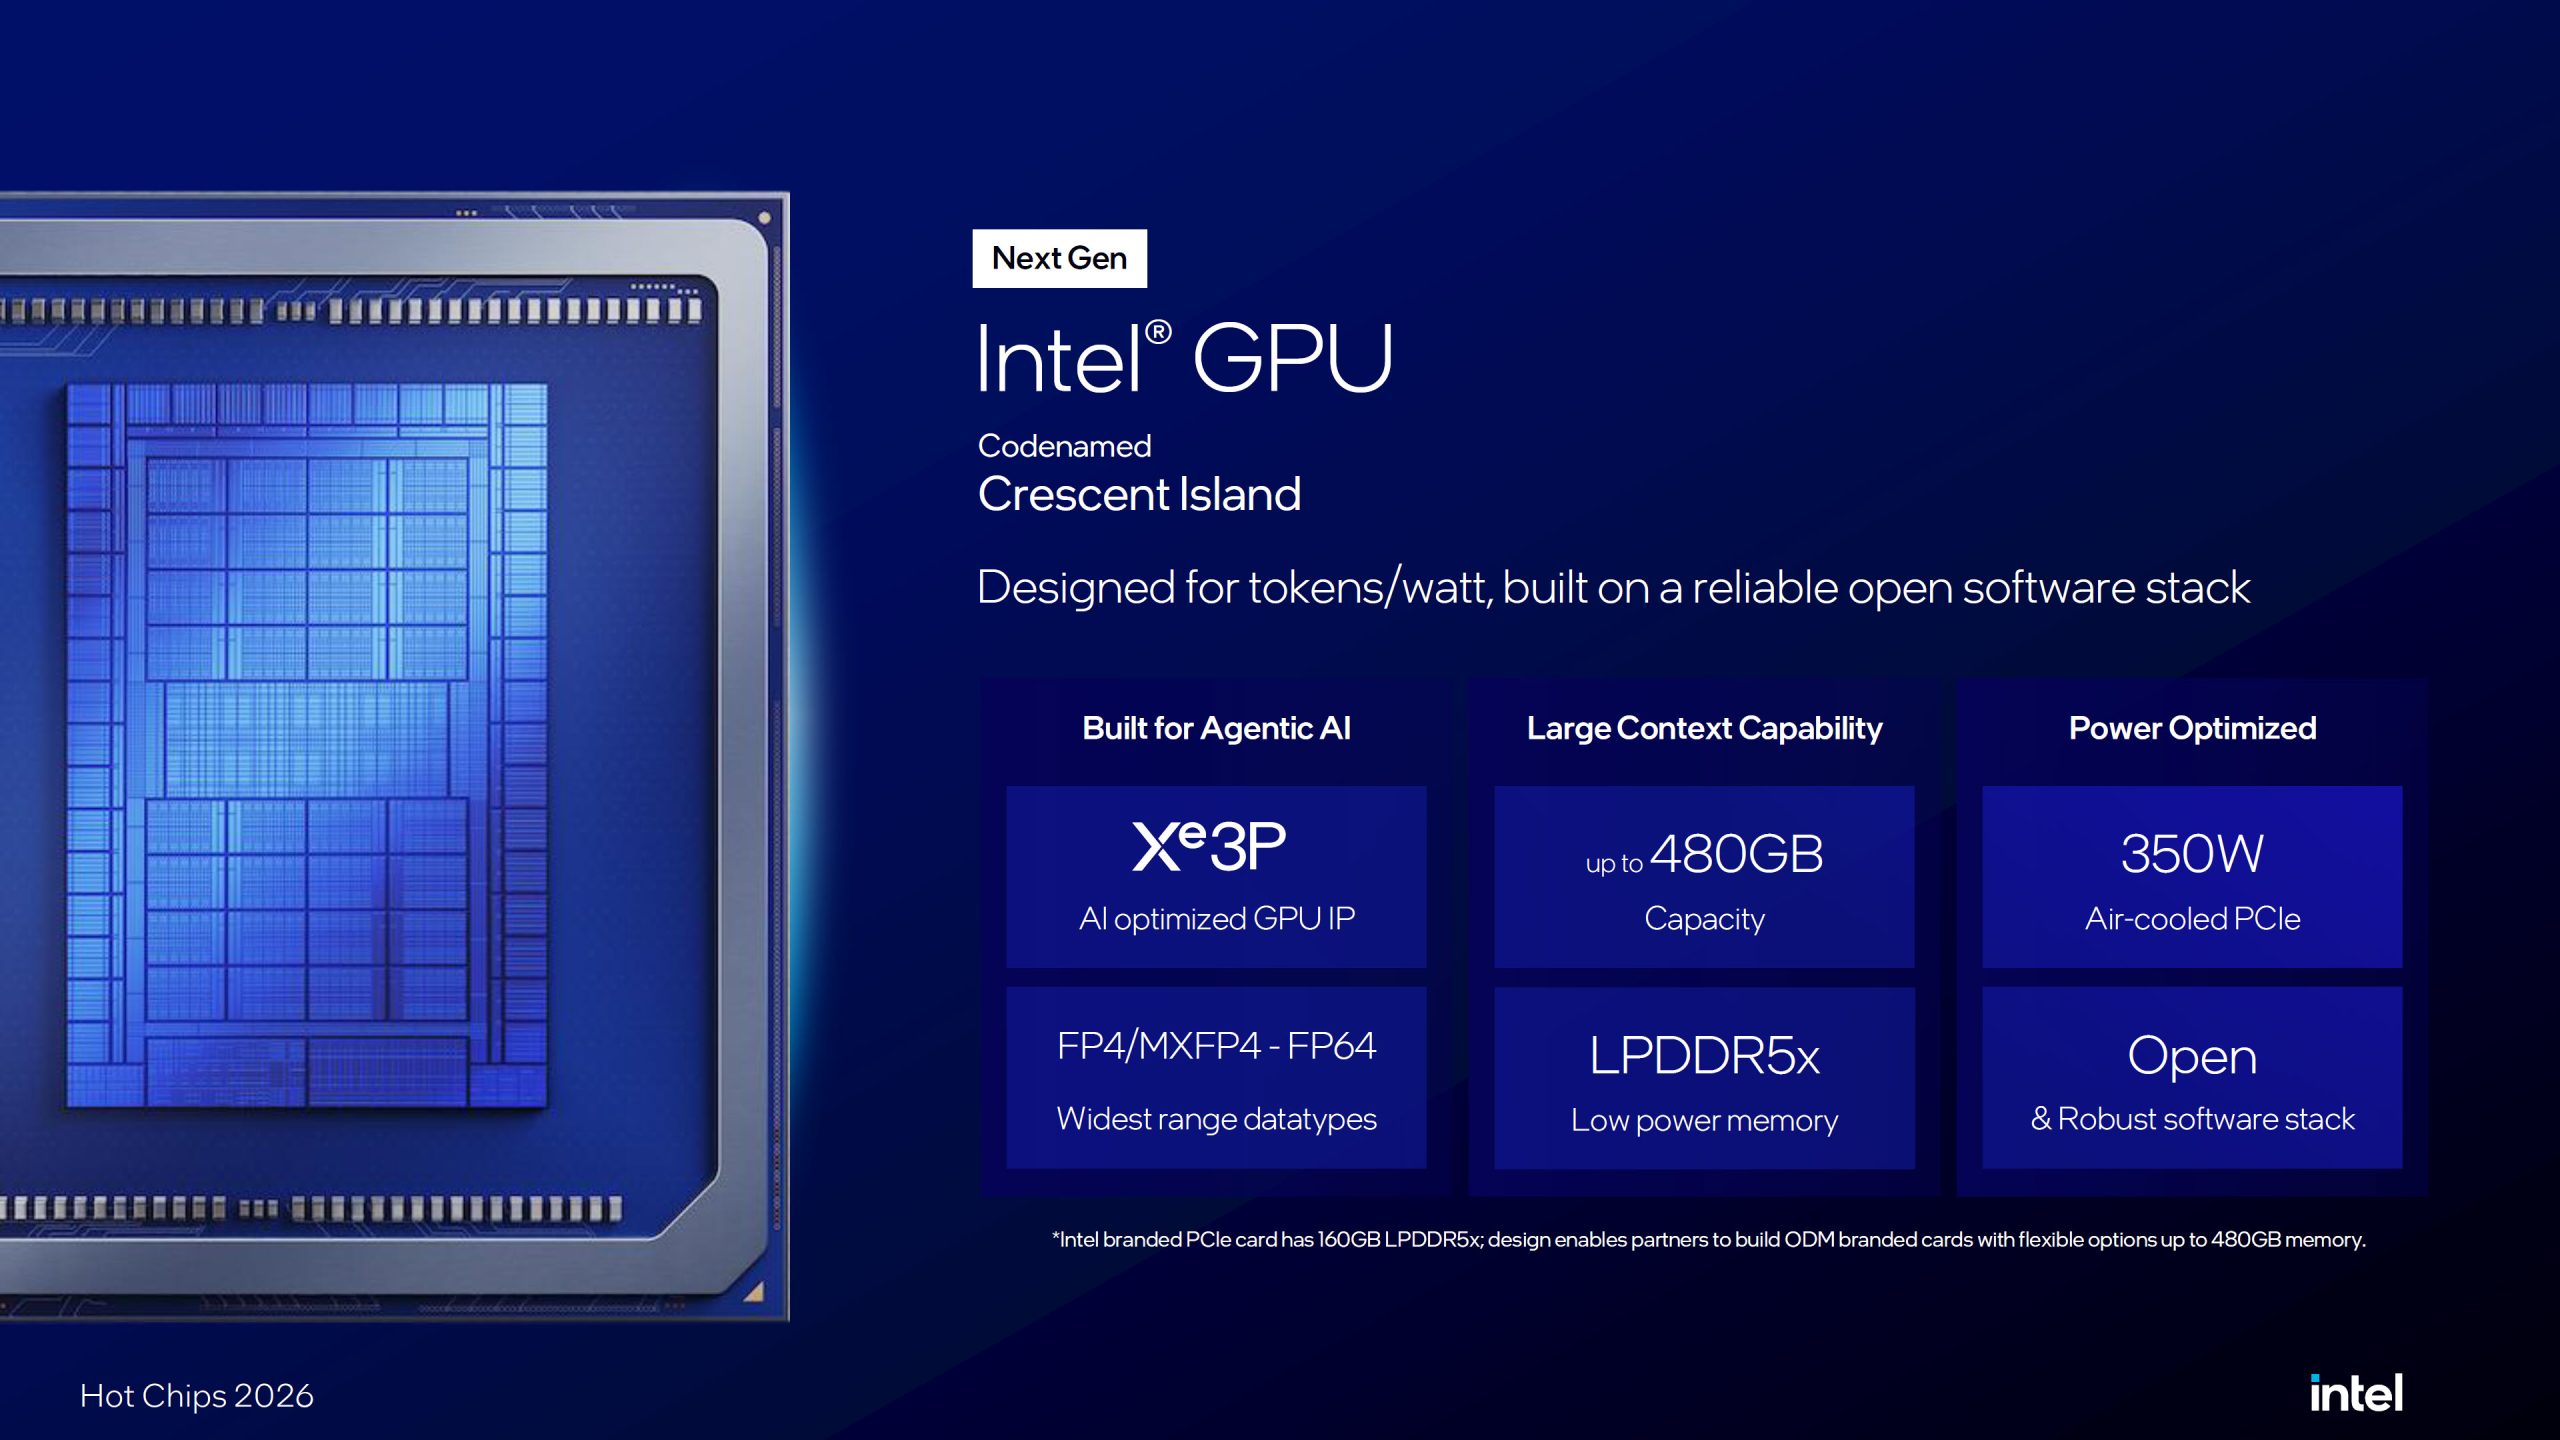
Intel positionne Crescent Island comme une solution optimisée en consommation et en coût. Elle vise les data centers et stations de travail refroidies par air et cible spécifiquement les charges de travail d’inférence IA. L’architecture Xe3P est affinée pour offrir le meilleur rapport performance par watt.
Face à des concurrents comme NVIDIA et AMD qui utilisent de la mémoire HBM3E de haut niveau, voire HBM4 pour leurs futures puces, Intel opte pour la LPDDR5X. L’approvisionnement en HBM est devenu plus difficile et coûteux, ce qui donne un avantage à la solution d’Intel. Pour comparer :
- Intel Crescent Island – Jusqu’à 480 Go (LPDDR5X)
- AMD Instinct MI450X – Jusqu’à 432 Go (HBM4)
- NVIDIA Vera Rubin – Jusqu’à 288 Go (HBM4)
L’IP Xe3P optimisée pour l’IA
Les GPU de la série D embarquent la 3e génération de l’architecture Xe, nommée Xe3P. Intel explique que cette architecture s’appuie sur une base installée multigénérationnelle et apporte de nouvelles améliorations en efficacité et compatibilité logicielle. Les GPU Crescent Island qui en sont équipés sont optimisés pour l’IA.
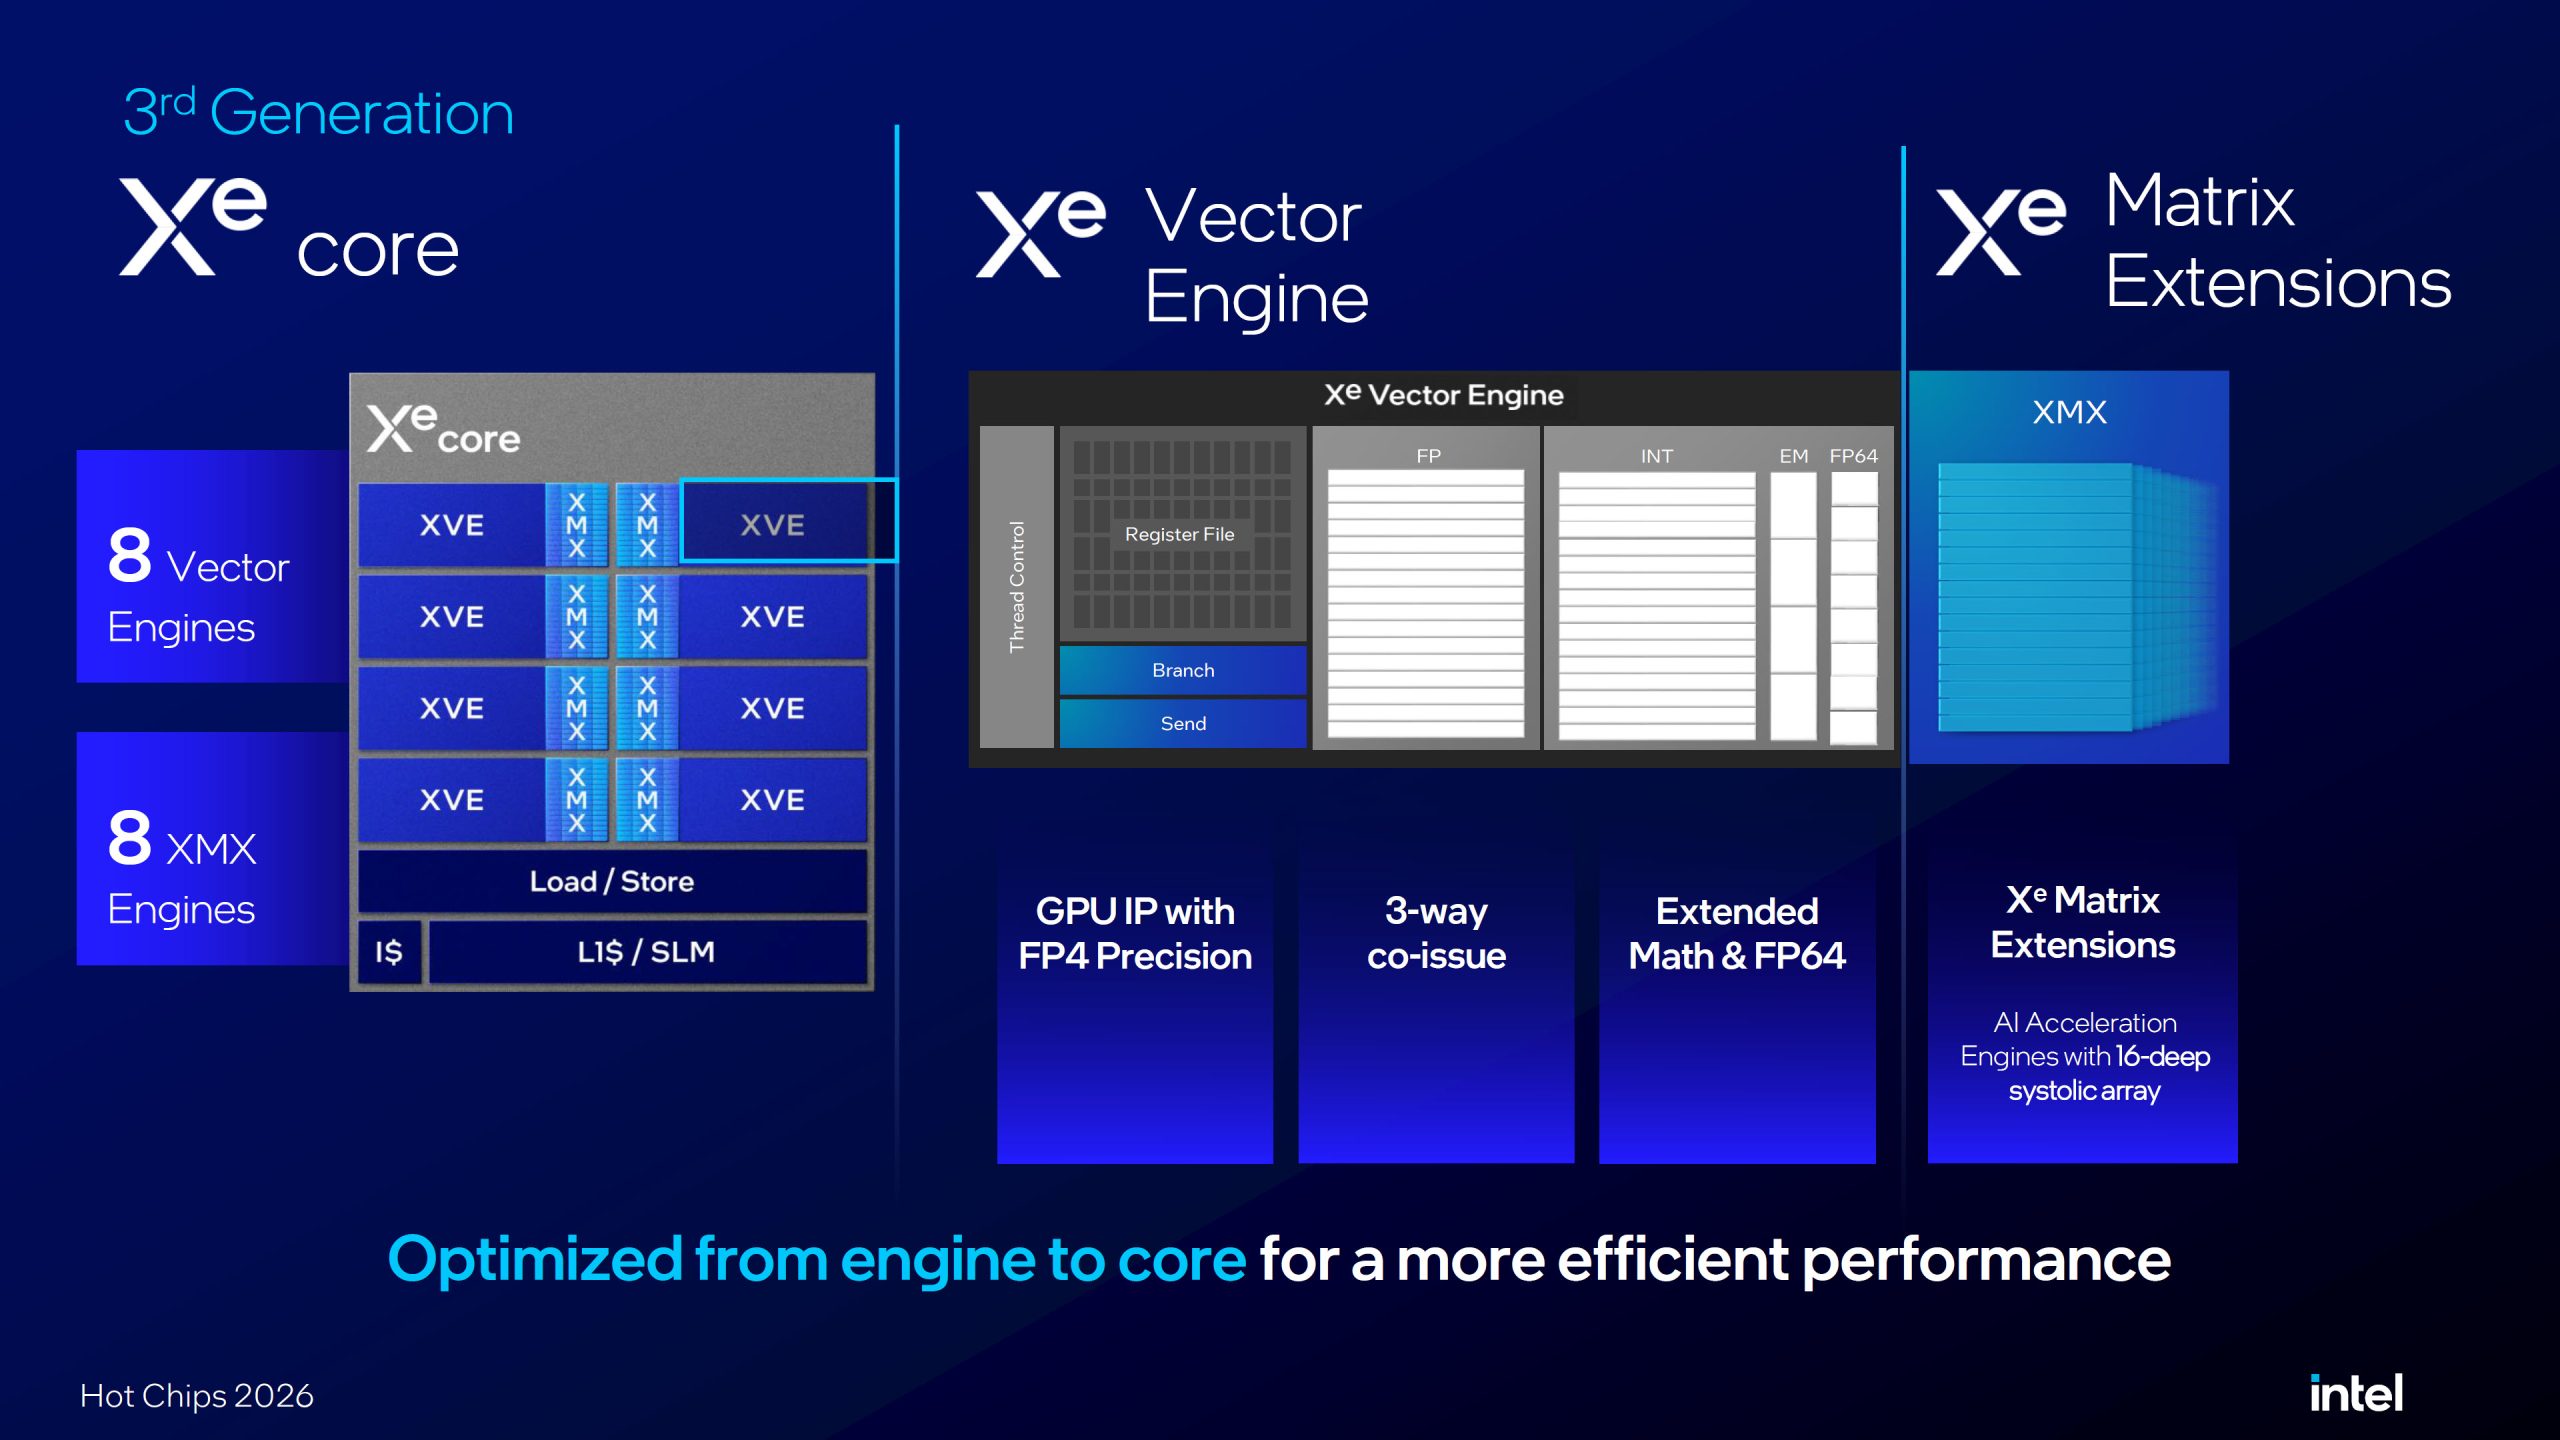
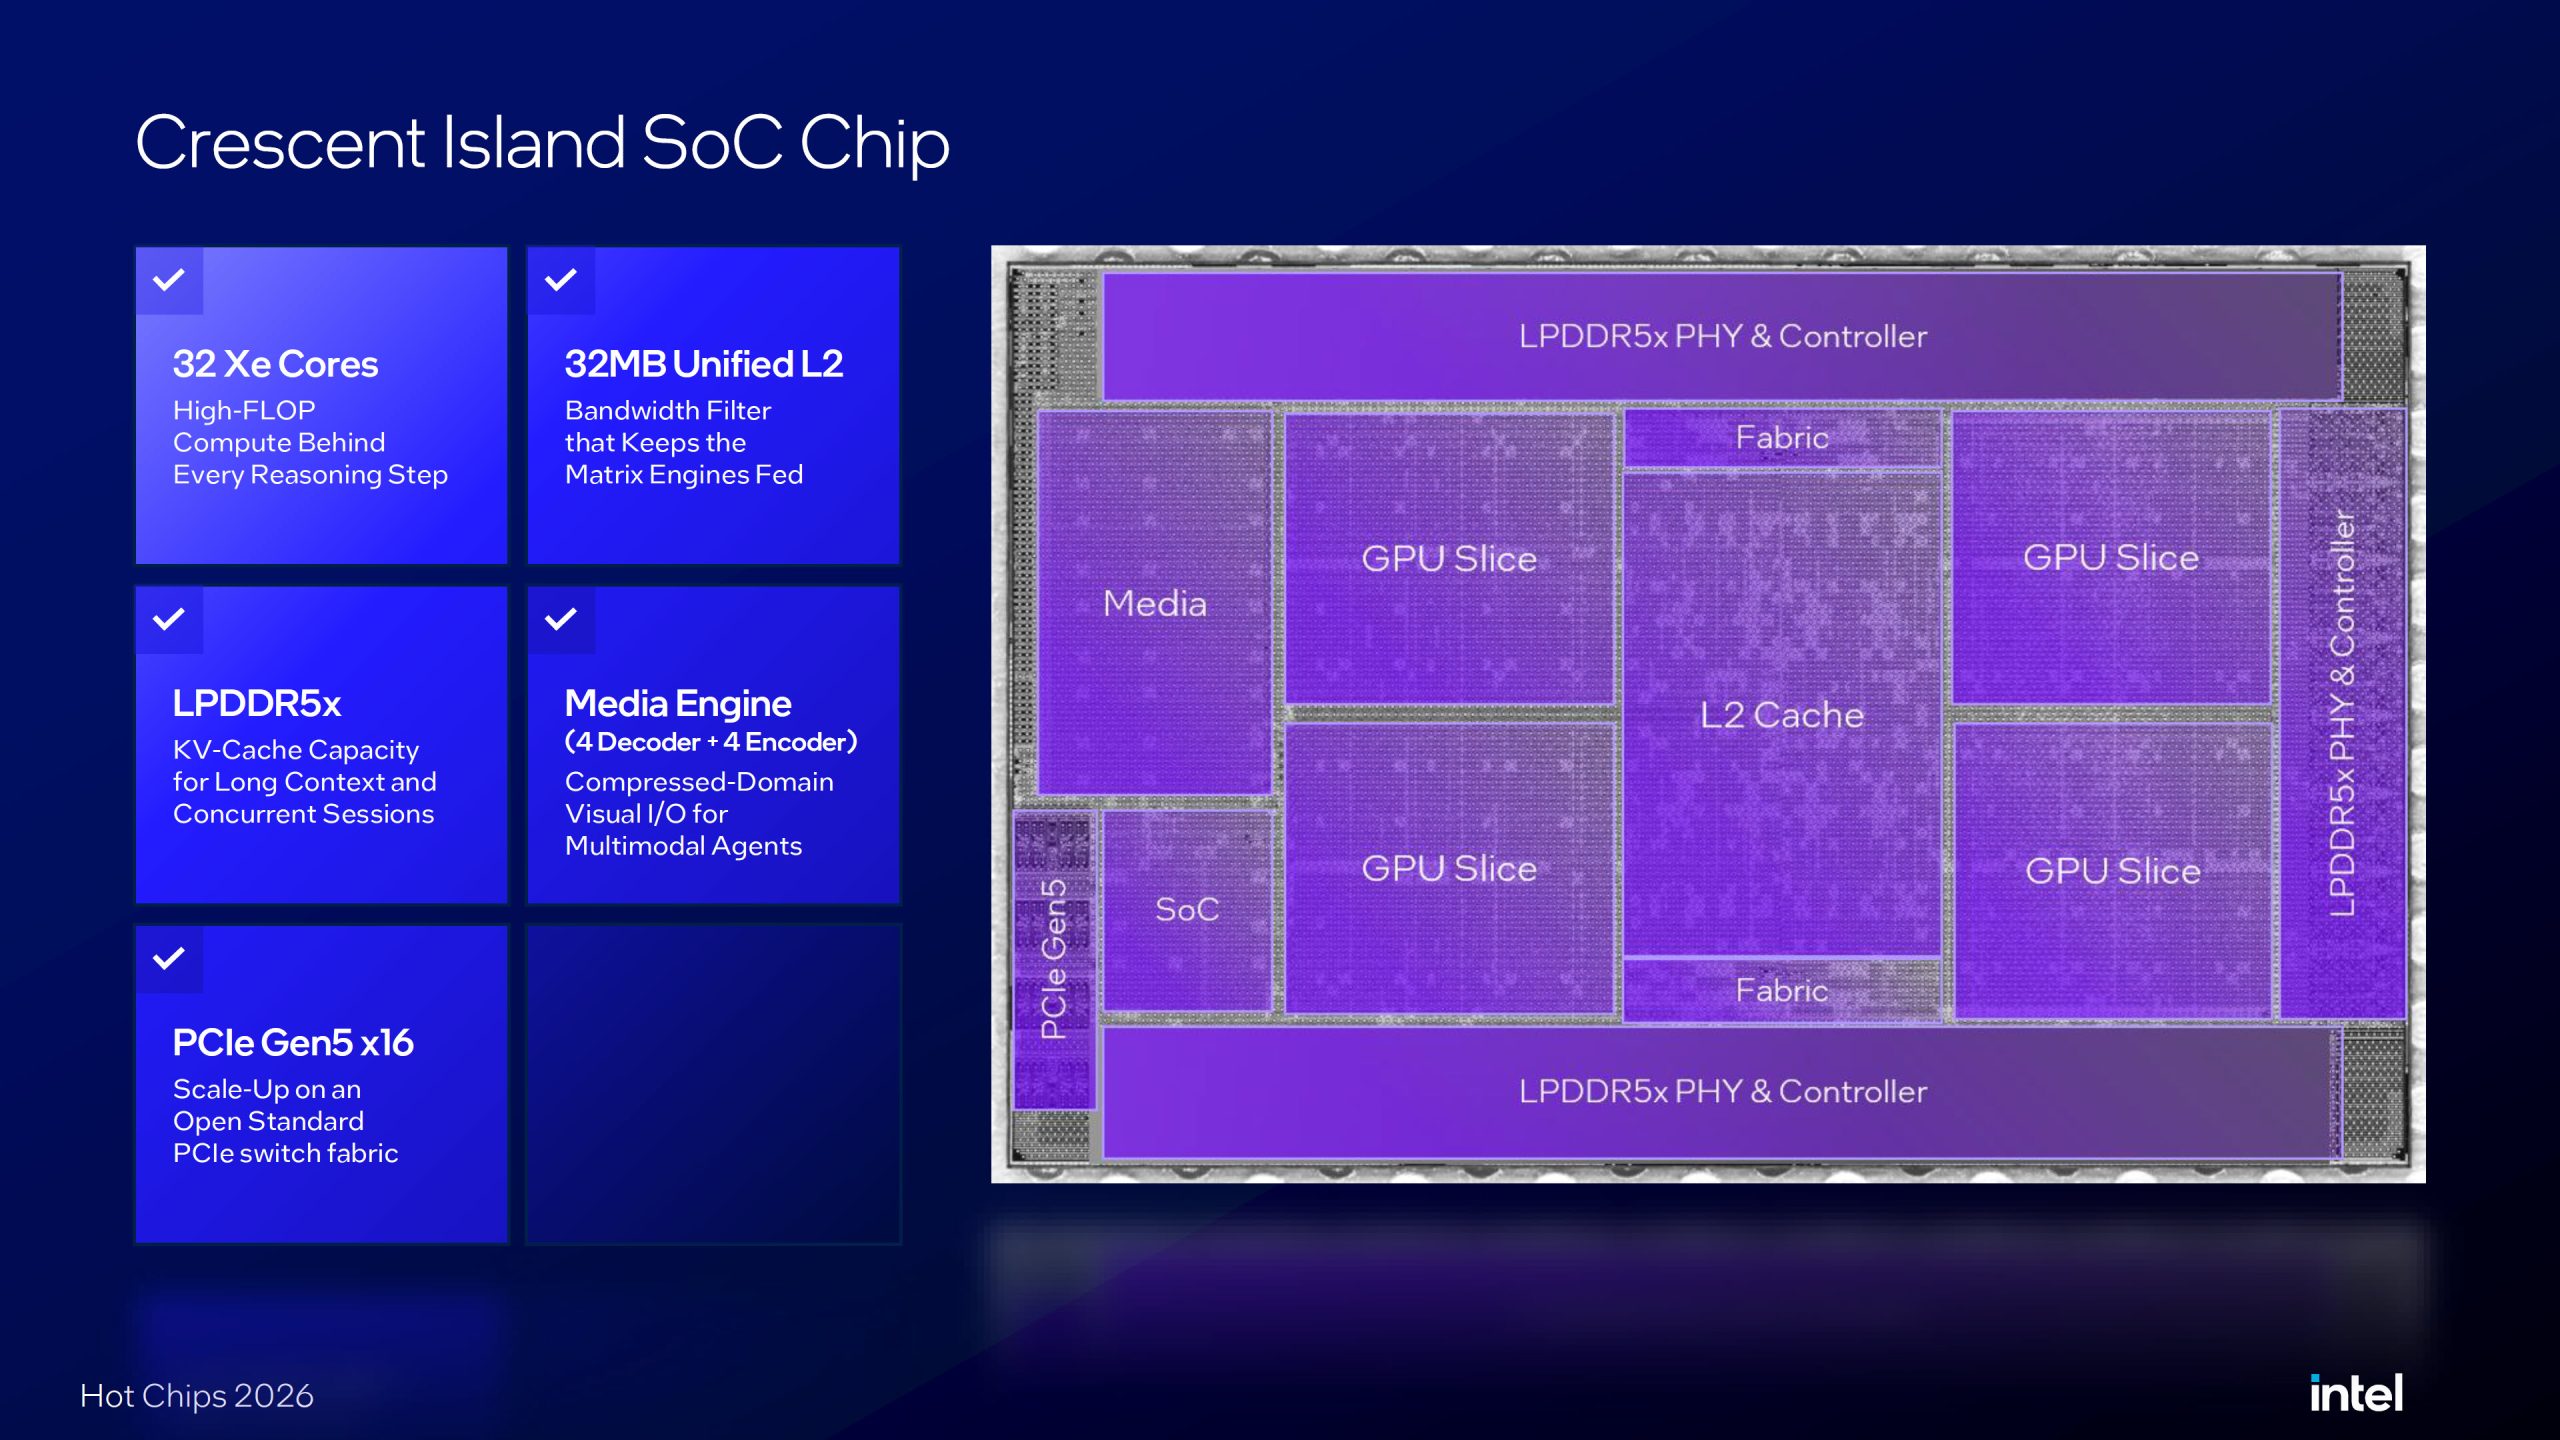
Au niveau architectural, le cœur Xe de 3e génération intègre 8 unités vectorielles et 8 moteurs XMX par cœur Xe. Le moteur vectoriel Xe gère désormais les précisions FP8 et FP4, une émission groupée à 3 voies, des capacités mathématiques étendues et FP64, tandis que les unités Xe Matrix Extensions proposent un réseau systolique de 16 éléments. Chaque cœur Xe dispose également de 1 Mo de GRD.
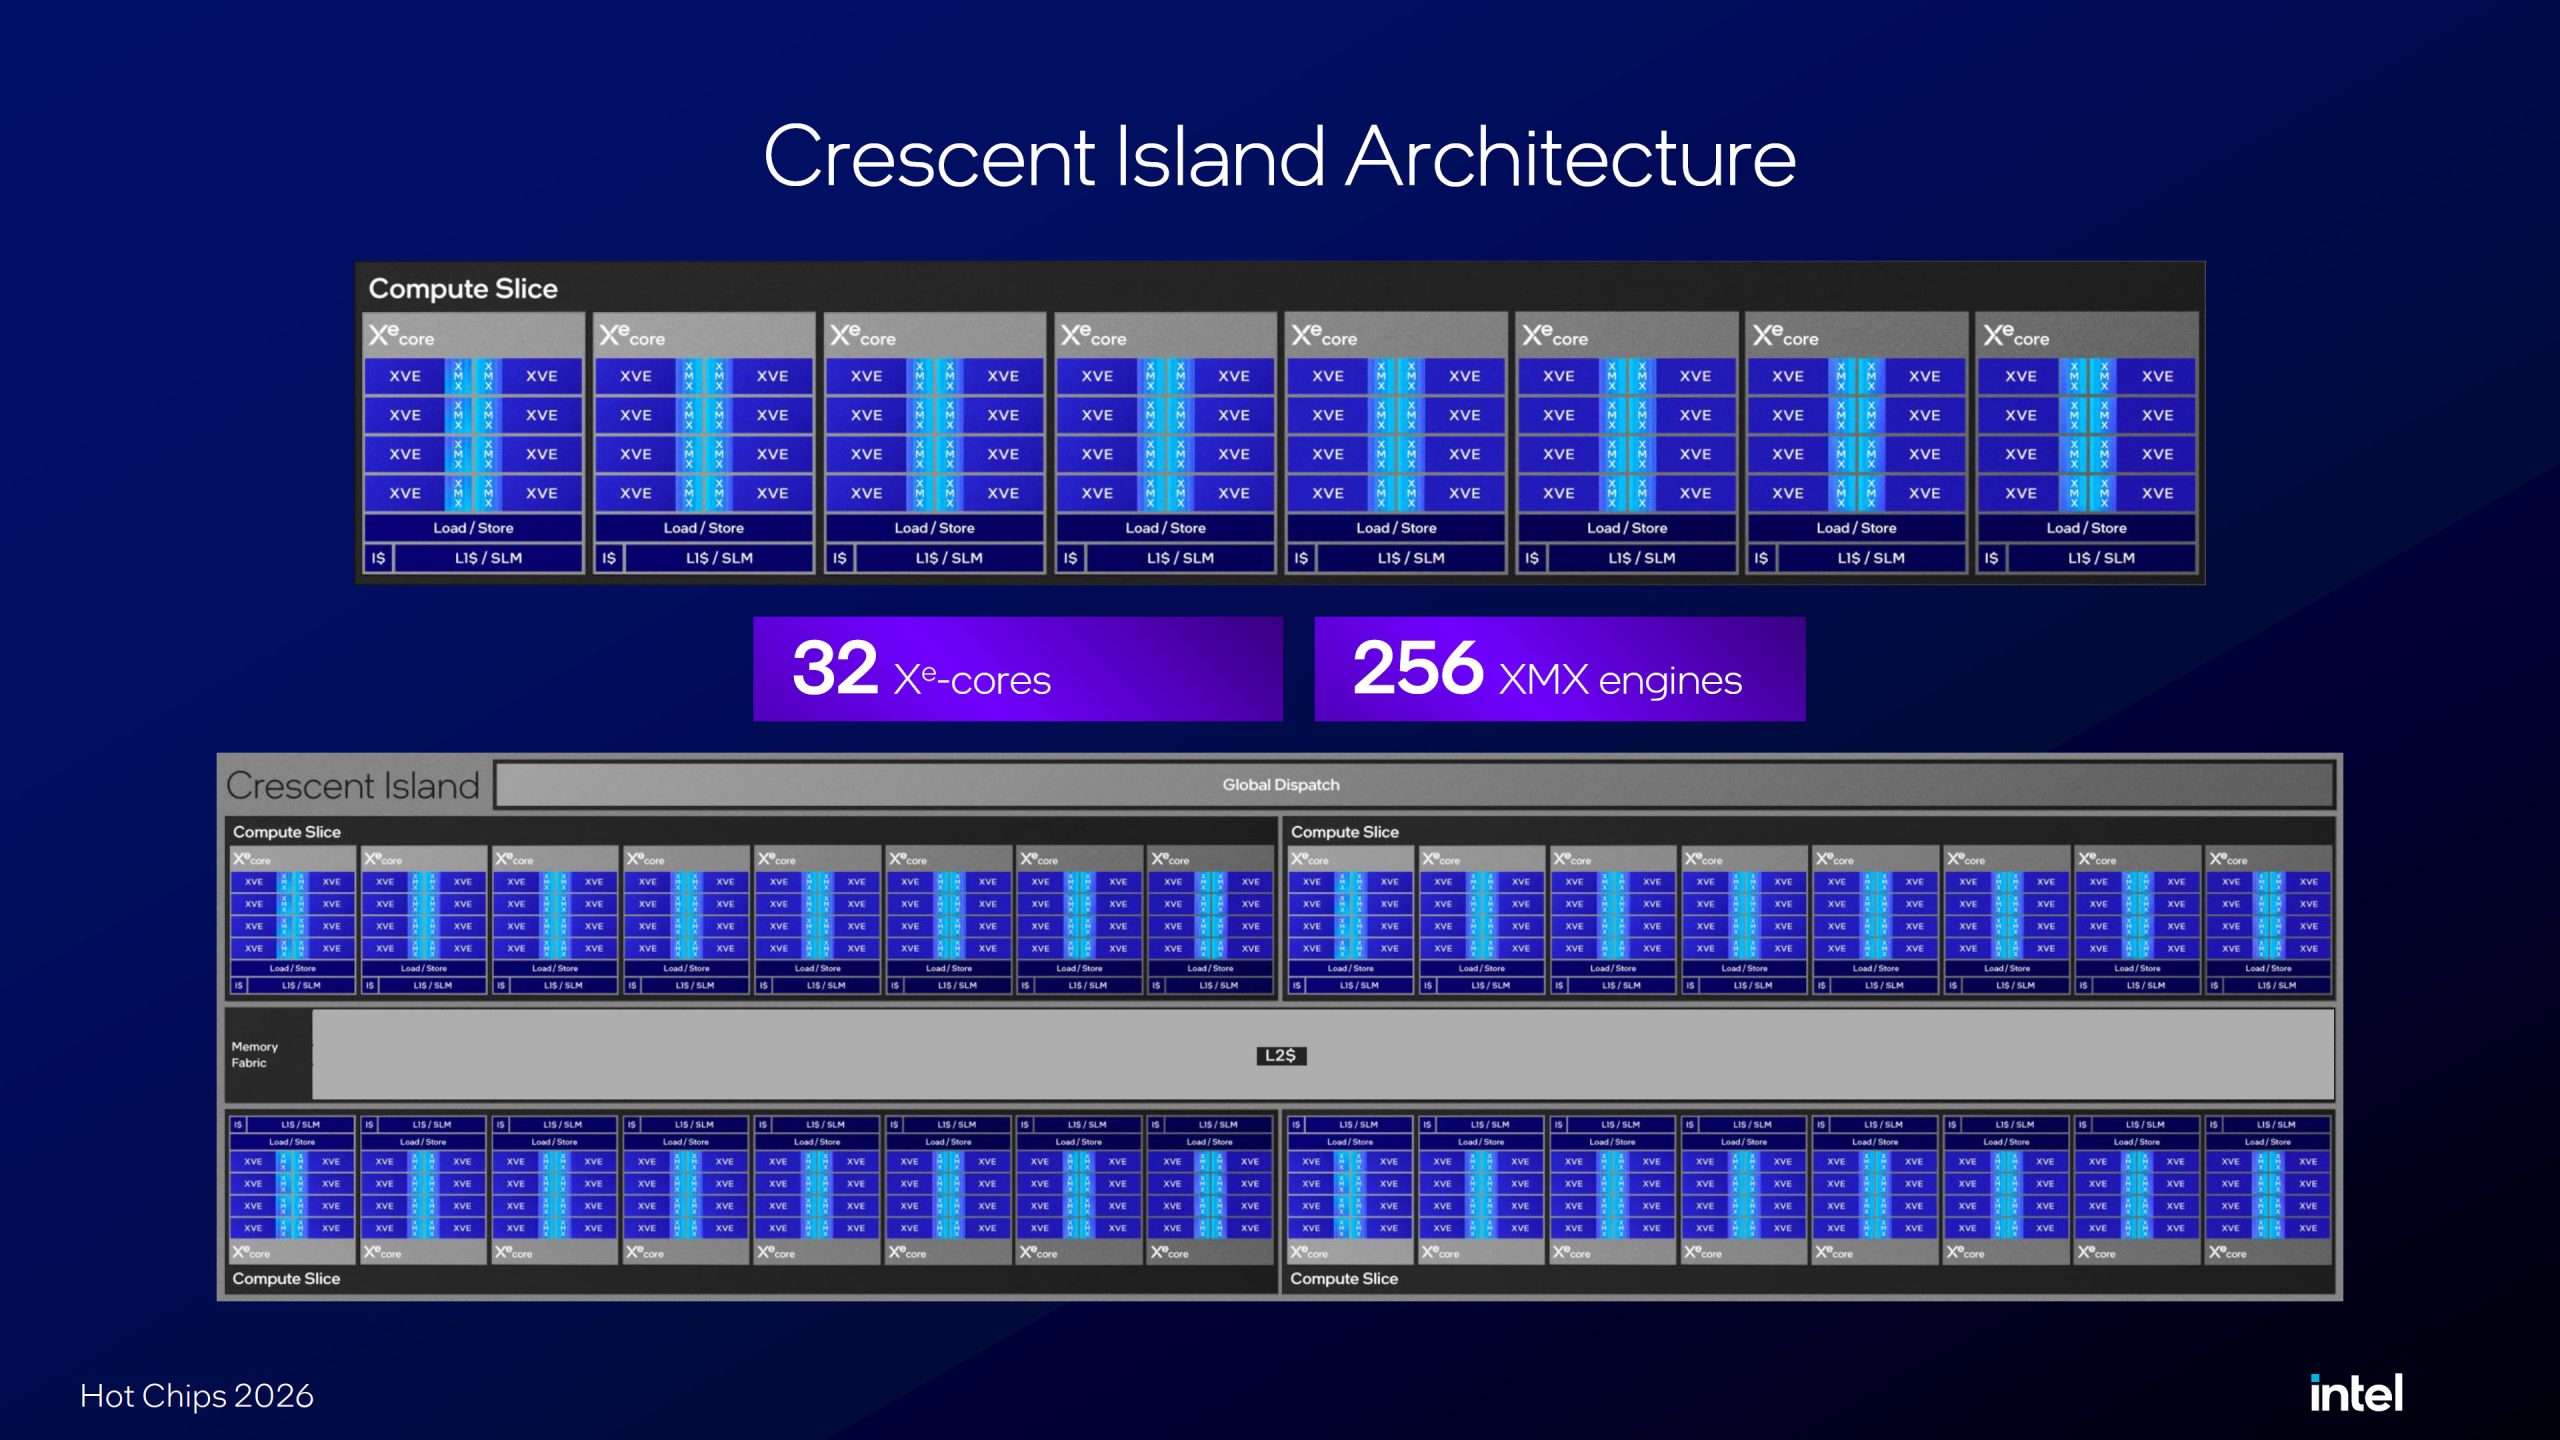
Le GPU Crescent Island est constitué de quatre tranches de calcul. Chaque tranche comprend 8 cœurs, ce qui donne un total de 32 cœurs Xe3P, 256 unités vectorielles et 256 unités XMX. Chaque cœur Xe conserve ses unités de chargement/stockage, son cache instruction dédié et son cache L1/SLM. Toutes les tranches de calcul sont connectées à un large cache L2 unifié.
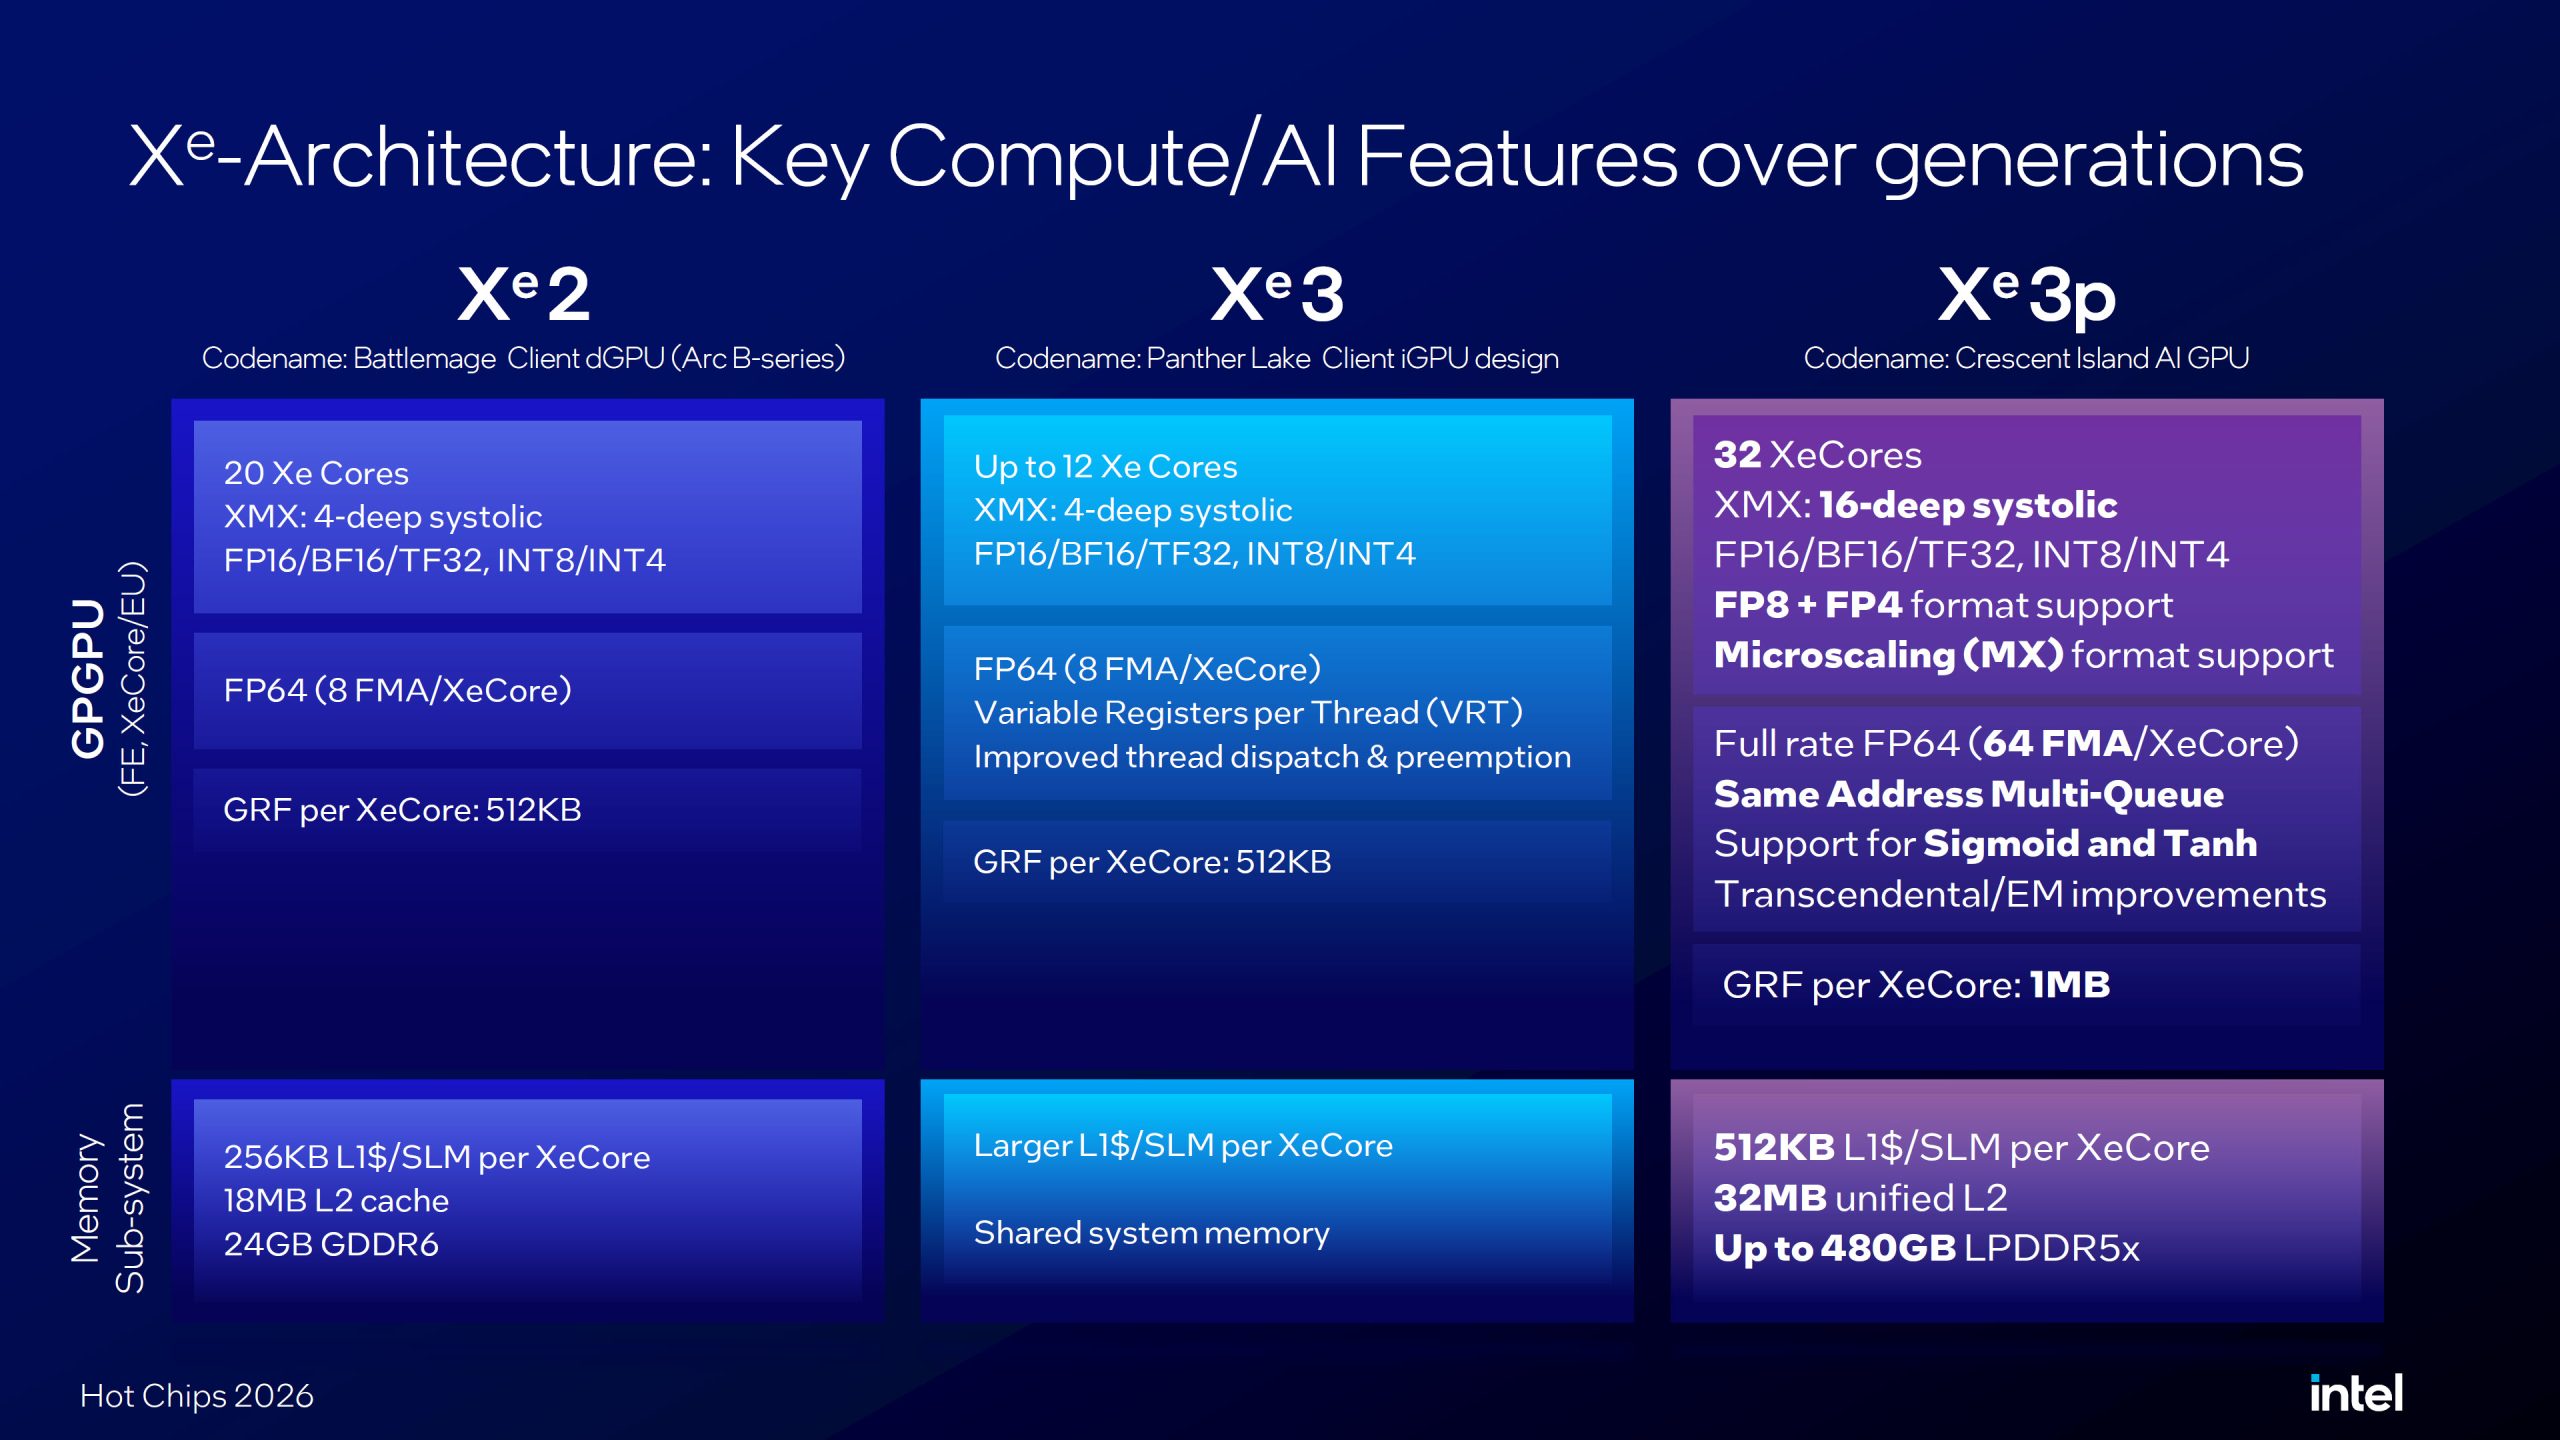
Pour le sous-système mémoire, le GPU Xe3P dispose de 512 Ko de cache L1/SLM par cœur Xe, soit 16 Mo au total, 32 Mo de cache L2 unifié, et jusqu’à 480 Go de mémoire LPDDR5X. Les solutions certifiées Intel intégreront 160 Go de LPDDR5X.
Que vaut 1,3 PFLOPs face aux options PCIe actuelles ?
Le détail le plus marquant partagé par Intel est que la série D offrira une puissance de calcul IA allant jusqu’à 1,3 PFLOPs pour une consommation de 350W. Une donnée qu’il est utile de comparer avec d’autres GPU du marché.
La carte AMD Radeon AI PRO R9700 atteint jusqu’à 766 TFLOPs en FP8, et jusqu’à 1,53 TOPS en calcul INT4 pour 300W. La NVIDIA RTX PRO 5500 Blackwell monte à 846 TFLOPs FP8 et 1,692 TFLOPs FP4 à 600W, tandis que la RTX PRO 5000 Blackwell atteint 535 TFLOPs FP8 et 1071 TFLOPs FP4. L’AMD Instinct MI350P va jusqu’à 2,3 PFLOPs avec du micro-scaling FP8. Cette comparaison positionne l’Intel D270 dans la gamme actuelle des options PCIe pour l’IA.
L’intégration de LPDDR5X à 160 Go (référence) et jusqu’à 480 Go (modèles partenaires) devrait également en faire un produit à bon rapport qualité-prix pour Intel.
« L’inférence devient la charge de travail IA déterminante, et les entreprises ont besoin d’une infrastructure qui offre la bonne performance au bon coût », explique Anil Nanduri, vice-président, Produits IA et GTM, Intel Data Center Group. « Avec le GPU Intel D-series, nous nous concentrons sur le déploiement pratique et l’extension économique de l’inférence à haute capacité. »
| GPU | Architecture | Pic FP8 | TDP | Mémoire | Type Mémoire | Bande Passante (Est./Rated) | Format / Refroidissement | Notes |
|---|---|---|---|---|---|---|---|---|
| Intel D270 (Crescent Island) | Xe3P (32 cœurs Xe, 256 XMX) | ~1,3 PFLOPs | 350 W | 160 Go (ref) / jusqu’à 480 Go | LPDDR5X | ~1,5 To/s (est., LPDDR5X-9600) | PCIe Gen5 x16, air | Optimisé préfill/inférence ; haute capacité pour cache KV ; exemplaires H2 2026 |
| AMD Radeon AI PRO R9700 | RDNA 4 (Navi 48) | 766 TFLOPs (sparse) / 383 TFLOPs (dense) | 300 W | 32 Go | GDDR6 | 640 Go/s | PCIe, air | Orientation station de travail ; structured sparsity |
| NVIDIA RTX PRO 5500 Blackwell | Blackwell (GB202) | ~846 TFLOPs (dense) | 600 W | 84 Go | GDDR7 ECC | ~1,4 To/s | PCIe Gen5 x16, air (ou liquide) | Fort débit matrice ; support MIG |
| NVIDIA RTX PRO 5000 Blackwell | Blackwell (GB202 réduit) | ~500–550 TFLOPs (est.) | 300 W | 48/72 Go | GDDR7 ECC | ~1,34 To/s | PCIe, air | Carte station de travail plus équilibrée |
| AMD Instinct MI350P | CDNA 4 | 2,3 PFLOPs (OCP-FP8 / MXFP8 pic) | 600 W (450W config.) | 144 Go | HBM3E | 4 To/s | PCIe Gen5 x16, air | Pic et bande passante élevés ; focus inférence entreprise |
La conception d’Intel privilégie les tokens par watt, l’inférence soutenue et le chargement de modèles ou de caches KV plus grands sur moins de cartes, plutôt que la maximisation des FLOPS bruts ou de la bande passante. Le choix du LPDDR5X réduit la consommation, le coût et les contraintes d’approvisionnement en HBM, au détriment de la bande passante crête.
La LPDDR5X réduit consommation et coûts
L’utilisation de la mémoire LPDDR5X pourrait donner à Intel un avantage dans le segment performance/coût. L’architecture supporte un large éventail de types de données, idéal pour les fournisseurs de « Tokens-as-a-service » et les cas d’usage d’inférence.
Le GPU Intel Crescent Island pour data centers disposera de jusqu’à 480 Go de mémoire LPDDR5X. La carte PCIe de référence d’Intel intégrera 160 Go, mais les partenaires pourront concevoir leurs propres cartes avec des options flexibles allant jusqu’à 480 Go.
L’usage de la LP5X réduit aussi significativement la consommation, avec un TDP de seulement 350W pour la version PCIe refroidie par air. Intel précise que cette mémoire permet une conception à canaux denses, augmentant la bande passante.
Autre particularité de Crescent Island : elle ne possède pas de blocs graphiques traditionnels comme le rendu 3D. La puce se concentre uniquement sur le GPGPU, libérant de la surface pour le calcul IA. Elle est optimisée pour la performance par watt et la performance par coût total de possession.
Déploiement simplifié sur les GPU Intel : Construite sur une fondation logicielle Xe commune, la série D supporte la portabilité logicielle à travers les plateformes GPU Intel, aidant les développeurs à réutiliser leurs applications et réduisant l’effort requis pour déployer des charges sur nouveau matériel.
Support « Day 0 » pour les nouveaux modèles ouverts : Grâce à l’intégration en amont dans les frameworks et l’activation des modèles, Intel travaille à supporter les nouveaux modèles ouverts dès leur disponibilité sur la série D et les processeurs Xeon. Des efforts récents incluent un support Day 0 pour Muse Glimmer de Meta, aidant les développeurs à évaluer et déployer plus rapidement les nouvelles charges de travail agentiques IA.
Le GPU sera accompagné d’un support large des formats de données, du FP4 au FP64, et d’une pile logicielle ouverte et robuste.
Intel évalue déjà sa pile logicielle unifiée pour les systèmes IA hétérogènes avec sa gamme actuelle Arc Pro B-series, permettant un accès anticipé à ces optimisations. La société cible des exemplaires clients pour son GPU Crescent Island au second semestre 2026.